阿富汗
奧蘭群島
阿爾巴尼亞
阿爾及利亞
美屬薩摩亞
安道爾
安哥拉
安圭拉
安提瓜和巴布達
阿根廷
亞美尼亞
阿魯巴
澳大利亞
奧地利
阿塞拜疆
巴哈馬
巴林
孟加拉
巴巴多斯
白俄羅斯
比利時
伯利茲
貝寧
百慕大
不丹
玻利維亞
博奈爾、聖尤斯特歇斯和薩巴
波斯尼亞和黑塞哥維那
博茨瓦納
布韋島
巴西
英屬印度洋領地
英屬維爾京群島
文萊
保加利亞
布基納法索
布隆迪
柬埔寨
喀麥隆
加拿大
佛得角
開曼群島
中非共和國
乍得
智利
中國
聖誕島
科科斯(基林)群島
哥倫比亞
科摩羅
剛果
庫克群島
哥斯達黎加
科特迪瓦
克羅地亞
庫拉索
塞浦路斯
捷克共和國
丹麥
吉布提
多米尼克
多米尼加共和國
厄瓜多爾
埃及
薩爾瓦多
赤道幾內亞
厄立特里亞
愛沙尼亞
埃塞俄比亞
福克蘭群島
法羅群島
斐濟
芬蘭
法國
法屬圭亞那
法屬波利尼西亞
法屬南部領地
加蓬
岡比亞
格魯吉亞
德國
加納
直布羅陀
希臘
格陵蘭
格林納達
瓜德羅普
關島
危地馬拉
根西島
幾內亞
幾內亞比紹
圭亞那
海地
赫德島和麥克唐納群島
梵蒂岡
洪都拉斯
香港
匈牙利
冰島
印度
印度尼西亞
伊拉克
愛爾蘭
馬恩島
以色列
意大利
牙買加
日本
澤西島
約旦
哈薩克斯坦
肯尼亞
基里巴斯
科威特
吉爾吉斯斯坦
老撾
拉脫維亞
黎巴嫩
萊索托
利比里亞
利比亞
列支敦士登
立陶宛
盧森堡
澳門
北馬其頓
馬達加斯加
馬拉維
馬來西亞
馬爾代夫
馬里
馬耳他
馬紹爾群島
馬提尼克
毛里塔尼亞
毛里求斯
馬約特
墨西哥
密克羅尼西亞
摩爾多瓦
摩納哥
蒙古
黑山
蒙特塞拉特
摩洛哥
莫桑比克
緬甸
納米比亞
瑙魯
尼泊爾
荷蘭
荷屬安的列斯
新喀里多尼亞
新西蘭
尼加拉瓜
尼日爾
尼日利亞
紐埃
諾福克島
北馬里亞納群島
挪威
阿曼
巴基斯坦
帕勞
巴勒斯坦
巴拿馬
巴布亞新幾內亞
巴拉圭
秘魯
菲律賓
皮特凱恩群島
波蘭
葡萄牙
波多黎各
卡塔爾
塞爾維亞
留尼汪
羅馬尼亞
俄羅斯
盧旺達
南喬治亞和南桑威奇群島
聖赫勒拿
聖基茨和尼維斯
聖盧西亞
聖馬丁
聖皮埃爾和密克隆
聖文森特和格林納丁斯
薩摩亞
聖馬力諾
聖多美和普林西比
沙特阿拉伯
塞內加爾
塞舌爾
塞拉利昂
新加坡
斯洛伐克
斯洛文尼亞
所羅門群島
索馬里
南非
韓國
西班牙
斯里蘭卡
蘇丹
蘇里南
斯瓦爾巴和揚馬延
斯威士蘭
瑞典
瑞士
台灣
塔吉克斯坦
坦桑尼亞
泰國
東帝汶
多哥
托克勞
湯加
特立尼達和多巴哥
突尼斯
土耳其
土庫曼斯坦
特克斯和凱科斯群島
圖瓦盧
美屬維爾京群島
烏干達
烏克蘭
阿聯酋
英國
美國
美國本土外小島嶼
烏拉圭
烏茲別克斯坦
瓦努阿圖
委內瑞拉
越南
瓦利斯和富圖納
西撒哈拉
也門
贊比亞
津巴布韋
未找到匹配項
+93-阿富汗
+355-阿爾巴尼亞
+213-阿爾及利亞
+1-美屬薩摩亞
+376-安道爾
+244-安哥拉
+1-安圭拉
+672-南極洲
+1-安提瓜和巴布達
+54-阿根廷
+374-亞美尼亞
+297-阿魯巴
+61-澳洲
+43-奧地利
+994-亞塞拜然
+1-巴哈馬
+973-巴林
+880-孟加拉
+1-巴貝多
+375-白俄羅斯
+32-比利時
+501-貝里斯
+229-貝南
+1-百慕達
+975-不丹
+591-玻利維亞
+387-波士尼亞與赫塞哥維納
+267-波札那
+55-巴西
+246-英屬印度洋領地
+673-汶萊
+359-保加利亞
+226-布吉納法索
+257-蒲隆地
+855-柬埔寨
+237-喀麥隆
+1-加拿大
+238-維德角
+1-開曼群島
+236-中非共和國
+235-查德
+56-智利
+86-中國
+61-聖誕島
+61-科科斯(基林)群島
+57-哥倫比亞
+269-葛摩
+243-剛果(金夏沙)
+242-剛果(布拉薩)
+682-庫克群島
+506-哥斯大黎加
+225-象牙海岸
+385-克羅埃西亞
+53-古巴
+357-賽普勒斯
+420-捷克
+45-丹麥
+253-吉布地
+1-多米尼克
+1-多明尼加共和國
+593-厄瓜多
+20-埃及
+503-薩爾瓦多
+240-赤道幾內亞
+291-厄利垂亞
+372-愛沙尼亞
+268-史瓦帝尼
+251-衣索比亞
+500-福克蘭群島
+298-法羅群島
+679-斐濟
+358-芬蘭
+33-法國
+594-法屬圭亞那
+689-法屬玻里尼西亞
+241-加彭
+220-甘比亞
+995-喬治亞
+49-德國
+233-迦納
+350-直布羅陀
+30-希臘
+299-格陵蘭
+1-格瑞那達
+590-瓜地洛普
+1-關島
+502-瓜地馬拉
+224-幾內亞
+245-幾內亞比索
+592-蓋亞那
+509-海地
+504-宏都拉斯
+852-香港
+36-匈牙利
+354-冰島
+91-印度
+62-印尼
+98-伊朗
+964-伊拉克
+353-愛爾蘭
+972-以色列
+39-義大利
+1-牙買加
+81-日本
+962-約旦
+7-哈薩克
+254-肯亞
+686-吉里巴斯
+850-北韓
+82-南韓
+965-科威特
+996-吉爾吉斯
+856-寮國
+371-拉脫維亞
+961-黎巴嫩
+266-賴索托
+231-賴比瑞亞
+218-利比亞
+423-列支敦斯登
+370-立陶宛
+352-盧森堡
+853-澳門
+261-馬達加斯加
+265-馬拉威
+60-馬來西亞
+960-馬爾地夫
+223-馬利
+356-馬爾他
+692-馬紹爾群島
+596-馬丁尼克
+222-茅利塔尼亞
+230-模里西斯
+262-馬約特
+52-墨西哥
+691-密克羅尼西亞
+373-摩爾多瓦
+377-摩納哥
+976-蒙古
+382-蒙特內哥羅
+1-蒙哲臘
+212-摩洛哥
+258-莫三比克
+95-緬甸
+264-納米比亞
+674-諾魯
+977-尼泊爾
+31-荷蘭
+687-新喀里多尼亞
+64-紐西蘭
+505-尼加拉瓜
+227-尼日
+234-奈及利亞
+683-紐埃
+672-諾福克島
+389-北馬其頓
+1-北馬里亞納群島
+47-挪威
+968-阿曼
+92-巴基斯坦
+680-帛琉
+970-巴勒斯坦
+507-巴拿馬
+675-巴布亞紐幾內亞
+595-巴拉圭
+51-秘魯
+63-菲律賓
+48-波蘭
+351-葡萄牙
+1-波多黎各
+974-卡達
+262-留尼旺
+40-羅馬尼亞
+7-俄羅斯
+250-盧安達
+590-聖巴瑟米
+290-聖赫勒拿
+1-聖克里斯多福及尼維斯
+1-聖露西亞
+590-聖馬丁
+508-聖皮埃與密克隆群島
+1-聖文森及格瑞那丁
+685-薩摩亞
+378-聖馬利諾
+239-聖多美普林西比
+966-沙烏地阿拉伯
+221-塞內加爾
+381-塞爾維亞
+248-塞席爾
+232-獅子山
+65-新加坡
+1-荷屬聖馬丁
+421-斯洛伐克
+386-斯洛維尼亞
+677-索羅門群島
+252-索馬利亞
+27-南非
+211-南蘇丹
+34-西班牙
+94-斯里蘭卡
+249-蘇丹
+597-蘇利南
+46-瑞典
+41-瑞士
+963-敘利亞
+886-台灣
+992-塔吉克
+255-坦尚尼亞
+66-泰國
+670-東帝汶
+228-多哥
+690-托克勞
+676-東加
+1-千里達及托巴哥
+216-突尼西亞
+90-土耳其
+993-土庫曼
+1-土克凱可群島
+688-吐瓦魯
+256-烏干達
+380-烏克蘭
+971-阿拉伯聯合大公國
+44-英國
+1-美國
+598-烏拉圭
+998-烏茲別克
+678-萬那杜
+58-委內瑞拉
+84-越南
+1-英屬維京群島
+1-美屬維京群島
+681-瓦利斯和富圖那
+967-葉門
+260-尚比亞
+263-辛巴威
未找到匹配項
產品
PDF 解決方案
企業版
LynxPDF for Windows
LynxPDF for Mac
LynxPDF for iOS
LynxPDF for Android
LynxPDF Web
管理後台
線上工具
所有工具
PDF 轉 Word
PDF 轉 Excel
PDF 轉 PPT
PDF 轉圖片
合併 PDF
壓縮 PDF
編輯 PDF
OCR PDF
批量 PDF 轉 Word
批量壓縮
功能
新增
所有功能
PDF 功能
編輯 PDF
轉換 PDF
註釋 PDF
簽名 PDF
填寫表單
閱讀 PDF
PDF OCR
AI 功能
AI PDF 摘要與報告產生
AI PDF 資料擷取
AI 合約審閱與風險檢查
AI PDF 安全與合規檢查
AI PDF 翻譯
AI PDF 助手
了解更多
產業解決方案
新增
產業解決方案
教育業
法律服務
政府與公共部門
醫療保健
金融
查看全部
工作流程解決方案
新增
紙本文件數位化流程
合約審查與風險標記
電子簽名審批
發票 PDF 歸檔
客戶導入
查看全部
安全與部署
新增
管理後台
單一登入
私有化部署
PDF 存取控制
Microsoft Intune
查看全部
資源
資源
常見問題
文章
白皮書
新增
客戶案例
關於我們
聯絡我們
GDPR
競品比較
定價
代理商
聯繫專人
免費下載
登入
English (U.S.)
English (Australia)
English (Canada)
English (U.K.)
Français
Français (Canada)
Español (México)
Español
العربية
Русский язык
中文 (简体)
中文 (繁體)
Português (Brasil)
Português (Portugal)
Deutsch
हिन्दी
Bahasa Indonesia
Bahasa Melayu
日本語 (にほんご)
Italiano
Nederlands
Türkçe
Polski
Українська
Svenska
Ελληνικά
ภาษาไทย (Phasa Thai)
Tiếng Việt
한국어
Română
Čeština
Magyar
Suomi
עברית
Norsk
Dansk
Slovenčina
Hrvatski
Català
English (U.S.)
English (Australia)
English (Canada)
English (U.K.)
Français
Français (Canada)
Español (México)
Español
العربية
Русский язык
中文 (简体)
中文 (繁體)
Português (Brasil)
Português (Portugal)
Deutsch
हिन्दी
Bahasa Indonesia
Bahasa Melayu
日本語 (にほんご)
Italiano
Nederlands
Türkçe
Polski
Українська
Svenska
Ελληνικά
ภาษาไทย (Phasa Thai)
Tiếng Việt
한국어
Română
Čeština
Magyar
Suomi
עברית
Norsk
Dansk
Slovenčina
Hrvatski
Català
產品
PDF 解決方案
企業版
LynxPDF for Windows
LynxPDF for Mac
LynxPDF for iOS
LynxPDF for Android
LynxPDF Web
管理後台
線上工具
所有工具
PDF 轉 Word
PDF 轉 Excel
PDF 轉 PPT
PDF 轉圖片
合併 PDF
壓縮 PDF
編輯 PDF
OCR PDF
批量 PDF 轉 Word
批量壓縮
功能
新增
所有功能
PDF 功能
編輯 PDF
轉換 PDF
註釋 PDF
簽名 PDF
填寫表單
閱讀 PDF
PDF OCR
AI 功能
AI PDF 摘要與報告產生
AI PDF 資料擷取
AI 合約審閱與風險檢查
AI PDF 安全與合規檢查
AI PDF 翻譯
AI PDF 助手
了解更多
產業解決方案
新增
產業解決方案
教育業
法律服務
政府與公共部門
醫療保健
金融
查看全部
工作流程解決方案
新增
紙本文件數位化流程
合約審查與風險標記
電子簽名審批
發票 PDF 歸檔
客戶導入
查看全部
安全與部署
新增
管理後台
單一登入
私有化部署
PDF 存取控制
Microsoft Intune
查看全部
資源
常見問題
文章
白皮書
新增
客戶案例
關於我們
聯絡我們
GDPR
競品比較
定價
代理商
聯繫專人
登入
免費下載
整批掃描 PDF,一次轉成
可搜尋內容
一次辨識多份掃描 PDF,將圖片中的文字轉換為可搜尋、可複製或可編輯的內容,加快文件數位化作業。
聯繫銷售團隊
免費試用
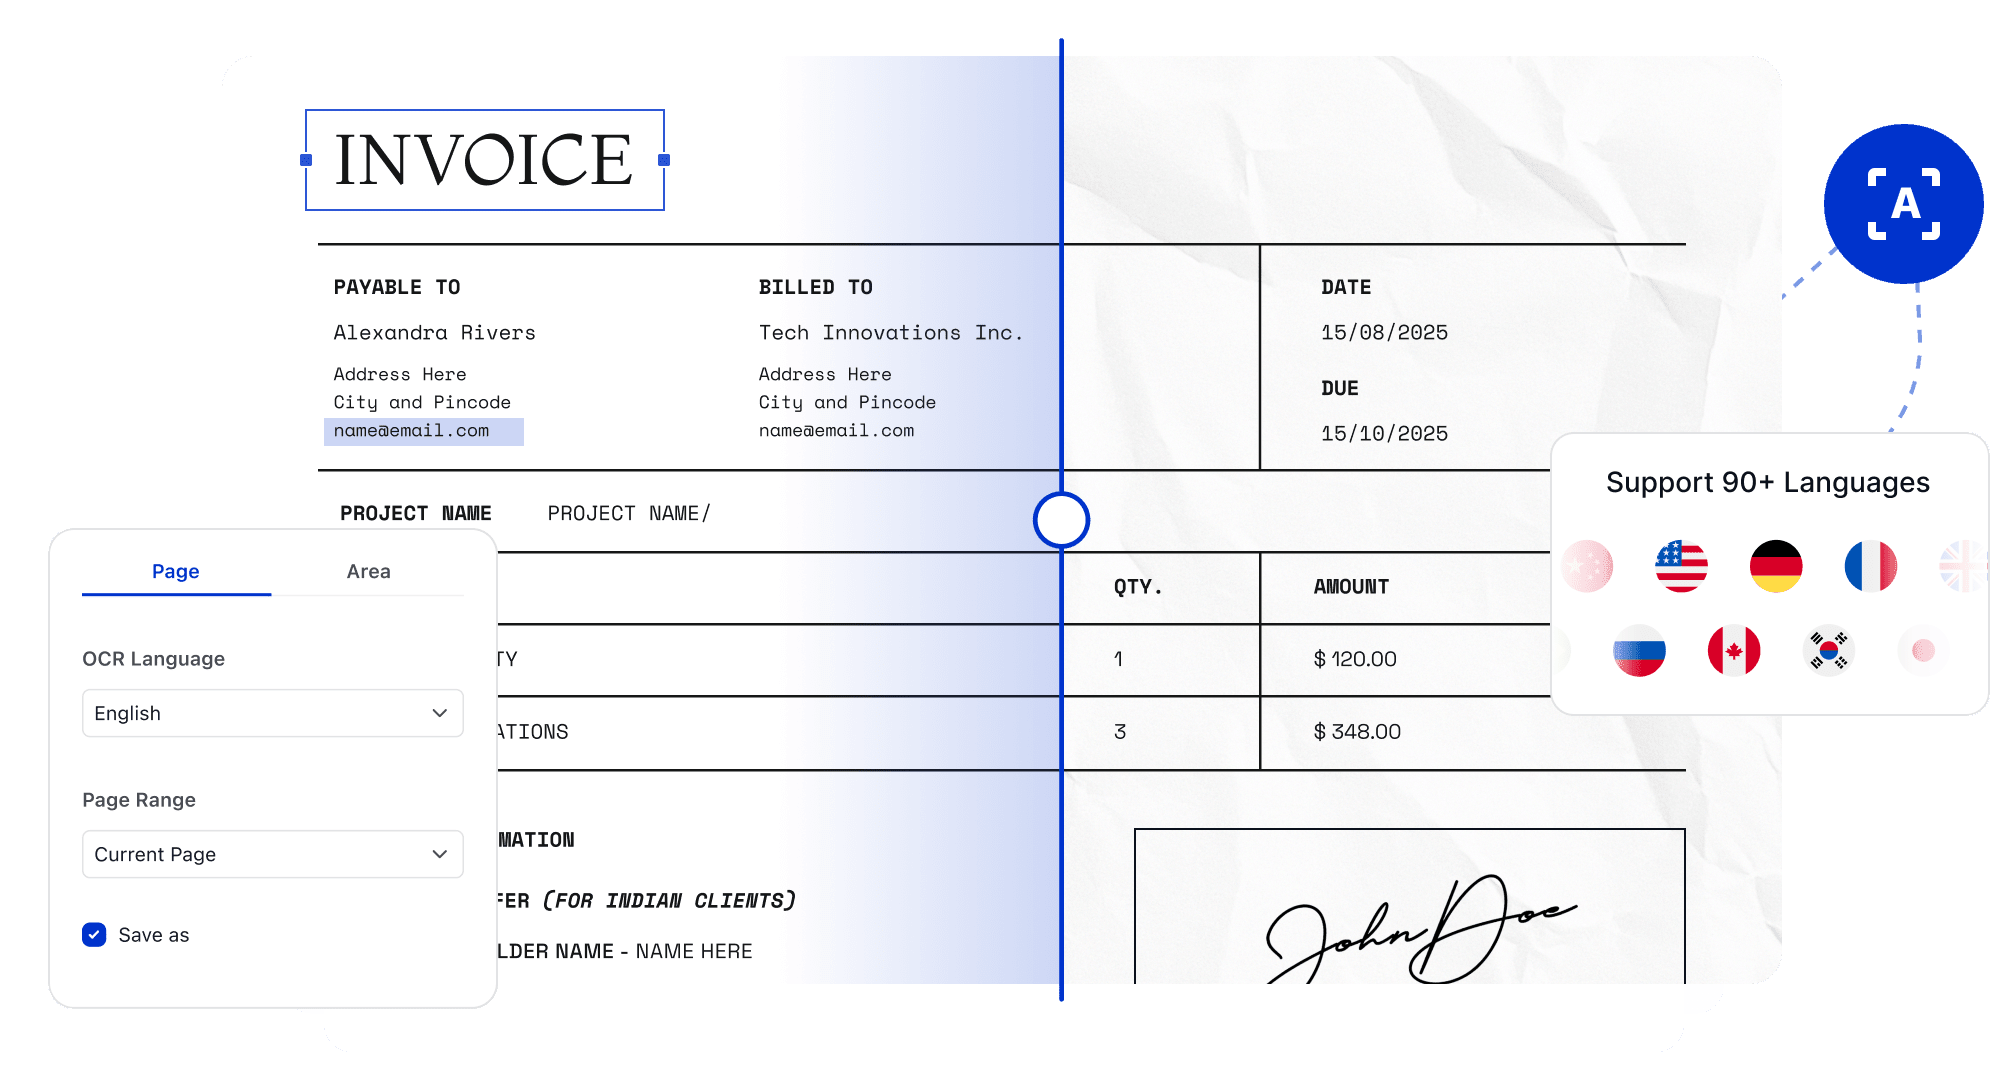
辨識掃描文件
針對掃描報告、合約和歷史資料進行 OCR 辨識,將圖片中的文字轉換為可搜尋內容,方便後續搜尋、複製與整理。
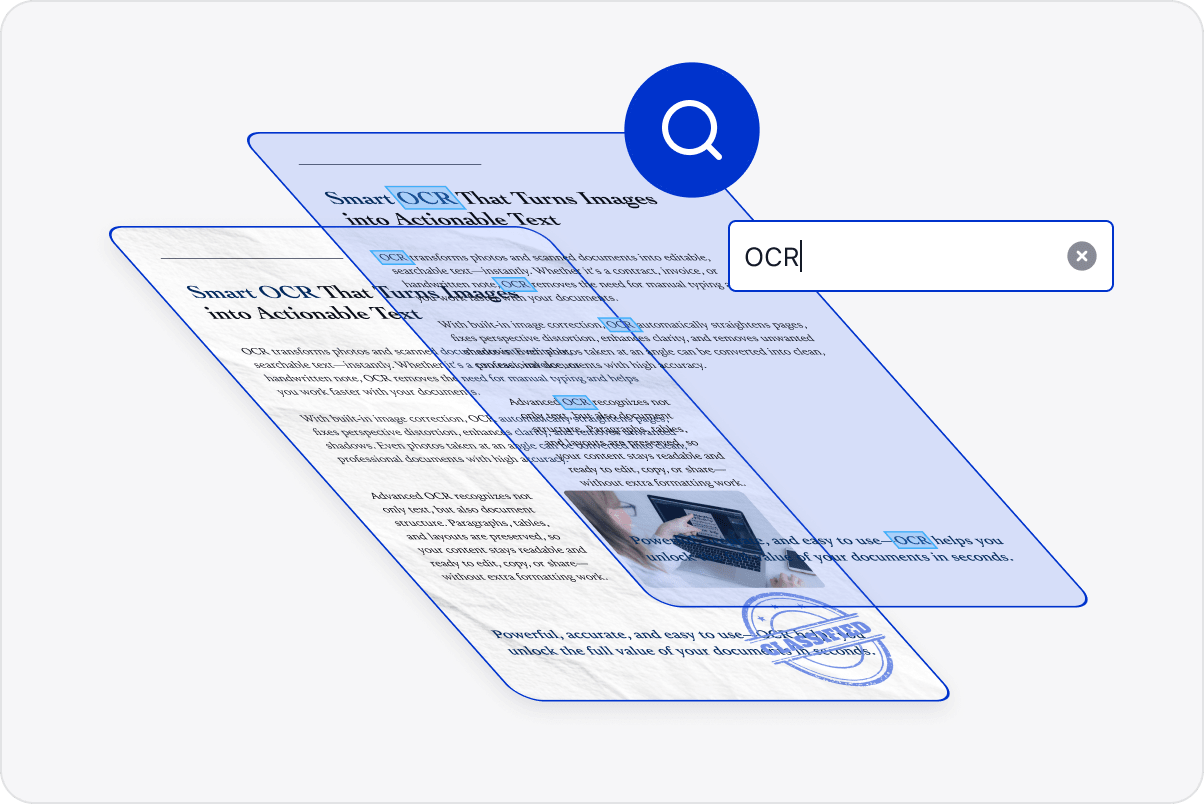
建立可搜尋文字層
為整批掃描文件建立文字層,讓團隊能透過關鍵字快速找到所需內容,減少逐頁開啟或手動翻找資料的作業。
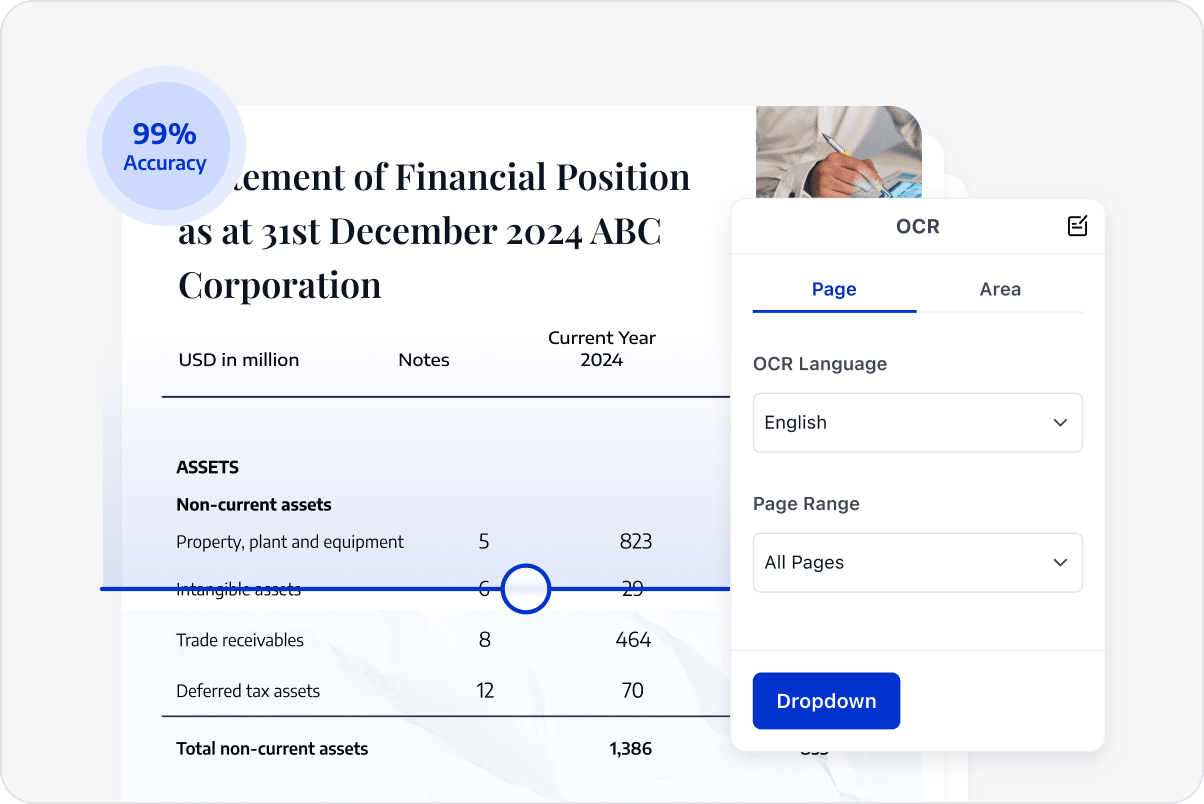
校正影像品質
透過影像校正處理傾斜、扭曲和變形的掃描頁面,改善辨識基礎,幫助文字、表格和頁面內容保持更清晰可讀。
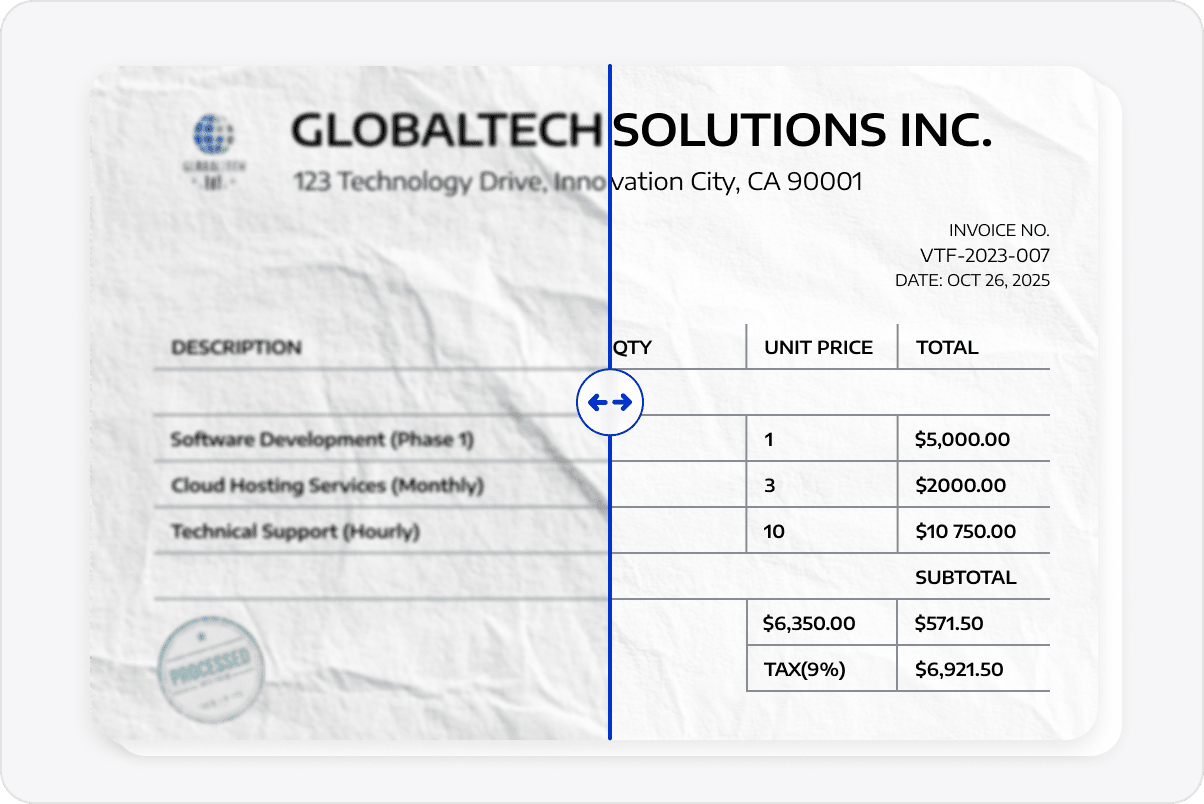
維持原有版面
辨識文字時盡可能保留原始頁面結構與視覺內容,讓掃描資料可繼續用於編輯、歸檔與資料擷取流程。
繼續編輯掃描資料
辨識後的掃描文件可繼續修改、複製與歸檔,讓歷史資料重新納入日常辦公與文件處理流程。
瀏覽 LynxPDF 白皮書
掌握企業文件管理的趨勢洞察與實務策略。
瀏覽所有白皮書
瀏覽所有白皮書
探索LynxPDF更多企業客製化功能
編輯
表單與簽名
安全
註釋
OCR
閱讀
探索教學與熱門文章
新手入門指南
Which File Formats Can I Convert Using LynxPDF?
How to activate LynxPDF through License Code?
LynxPDF vs Kofax Power PDF
Why LynxPDF is the Best Adobe Acrobat Alternative for Enterprise Use?
How about LynxPDF’s OCR, and What are Its Main Advantages?
Does LynxPDF Support Batch Processing?
Does LynxPDF Support Digital Signatures?
Does LynxPDF Support Web, Mobile, and Team Collaboration?
更多常見問題
熱門精選文章
ABBYY FineReader PDF Alternative: Enterprise PDF Management Comparison
Thu. 27 Aug. 2026
Sejda vs LynxPDF: Linux Flexibility or Managed PDF Operations?
Wed. 26 Aug. 2026
Smallpdf vs LynxPDF: When PDF Work Needs More Control
Wed. 26 Aug. 2026
更多文章
聯絡業務團隊
我們樂意為您解答任何 LynxPDF 相關問題。填寫下列表單後,業務代表將主動與您聯絡。
免費試用 LynxPDF 與管理控制台 14 天。
為您的團隊選擇合適的定價方案。
探索適合團隊需求的應用情境與案例。
最高可享 50% 大量授權折扣
大量採購,享最高 50% 折扣
公司 Email
姓名
公司名稱
國家/地區
搜尋並選擇
電話號碼
搜尋並選擇
-
描述您的需求
0 / 1000