アフガニスタン
オーランド諸島
アルバニア
アルジェリア
アメリカ領サモア
アンドラ
アンゴラ
アンギラ
アンティグア・バーブーダ
アルゼンチン
アルメニア
アルバ
オーストラリア
オーストリア
アゼルバイジャン
バハマ
バーレーン
バングラデシュ
バルバドス
ベラルーシ
ベルギー
ベリーズ
ベナン
バミューダ
ブータン
ボリビア
ボネール、シント・ユースタティウスおよびサバ
ボスニア・ヘルツェゴビナ
ボツワナ
ブーベ島
ブラジル
イギリス領インド洋地域
イギリス領ヴァージン諸島
ブルネイ・ダルサラーム
ブルガリア
ブルキナファソ
ブルンジ
カンボジア
カメルーン
カナダ
カーボベルデ
ケイマン諸島
中央アフリカ共和国
チャド
チリ
中国
クリスマス島
ココス諸島
コロンビア
コモロ
コンゴ
クック諸島
コスタリカ
コートジボワール
クロアチア
キュラソー
キプロス
チェコ共和国
デンマーク
ジブチ
ドミニカ
ドミニカ共和国
エクアドル
エジプト
エルサルバドル
赤道ギニア
エリトリア
エストニア
エチオピア
フォークランド諸島
フェロー諸島
フィジー
フィンランド
フランス
フランス領ギアナ
フランス領ポリネシア
フランス領南方・南極地域
ガボン
ガンビア
ジョージア
ドイツ
ガーナ
ジブラルタル
ギリシャ
グリーンランド
グレナダ
グアドループ
グアム
グアテマラ
ガーンジー
ギニア
ギニアビサウ
ガイアナ
ハイチ
ハード島とマクドナルド諸島
バチカン市国
ホンジュラス
香港
ハンガリー
アイスランド
インド
インドネシア
イラク
アイルランド
マン島
イスラエル
イタリア
ジャマイカ
日本
ジャージー
ヨルダン
カザフスタン
ケニア
キリバス
クウェート
キルギス
ラオス人民民主共和国
ラトビア
レバノン
レソト
リベリア
リビア
リヒテンシュタイン
リトアニア
ルクセンブルク
マカオ
北マケドニア
マダガスカル
マラウイ
マレーシア
モルディブ
マリ
マルタ
マーシャル諸島
マルティニーク
モーリタニア
モーリシャス
マヨット
メキシコ
ミクロネシア連邦
モルドバ
モナコ
モンゴル
モンテネグロ
モントセラト
モロッコ
モザンビーク
ミャンマー
ナミビア
ナウル
ネパール
オランダ
オランダ領アンティル
ニューカレドニア
ニュージーランド
ニカラグア
ニジェール
ナイジェリア
ニウエ
ノーフォーク島
北マリアナ諸島
ノルウェー
オマーン
パキスタン
パラオ
パレスチナ自治区
パナマ
パプアニューギニア
パラグアイ
ペルー
フィリピン
ピトケアン諸島
ポーランド
ポルトガル
プエルトリコ
カタール
セルビア
レユニオン
ルーマニア
ロシア連邦
ルワンダ
サウスジョージア・サウスサンドウィッチ諸島
セントヘレナ
セントクリストファー・ネイビス
セントルシア
サン・マルタン
サンピエール島・ミクロン島
セントビンセント・グレナディーン
サモア
サンマリノ
サントメ・プリンシペ
サウジアラビア
セネガル
セーシェル
シエラレオネ
シンガポール
スロバキア
スロベニア
ソロモン諸島
ソマリア
南アフリカ
韓国
スペイン
スリランカ
スーダン
スリナム
スバールバル諸島・ヤンマイエン島
エスワティニ
スウェーデン
スイス
台湾
タジキスタン
タンザニア
タイ
東ティモール
トーゴ
トケラウ
トンガ
トリニダード・トバゴ
チュニジア
トルコ
トルクメニスタン
タークス・カイコス諸島
ツバル
アメリカ領ヴァージン諸島
ウガンダ
ウクライナ
アラブ首長国連邦
イギリス
アメリカ合衆国
アメリカ合衆国領有小離島
ウルグアイ
ウズベキスタン
バヌアツ
ベネズエラ
ベトナム
ウォリス・フツナ
西サハラ
イエメン
ザンビア
ジンバブエ
一致するものがありません
+93-アフガニスタン
+355-アルバニア
+213-アルジェリア
+1-アメリカ領サモア
+376-アンドラ
+244-アンゴラ
+1-アンギラ
+72-南極
+1-アンティグア・バーブーダ
+54-アルゼンチン
+374-アルメニア
+297-アルバ
+61-オーストラリア
+43-オーストリア
+994-アゼルバイジャン
+1-バハマ
+973-バーレーン
+880-バングラデシュ
+1-バルバドス
+375-ベラルーシ
+32-ベルギー
+501-ベリーズ
+229-ベナン
+1-バミューダ
+975-ブータン
+591-ボリビア
+387-ボスニア・ヘルツェゴビナ
+267-ボツワナ
+55-ブラジル
+246-英領インド洋地域
+673-ブルネイ
+359-ブルガリア
+226-ブルキナファソ
+257-ブルンジ
+855-カンボジア
+237-カメルーン
+1-カナダ
+238-カーボベルデ
+1-ケイマン諸島
+236-中央アフリカ共和国
+235-チャド
+56-チリ
+86-中国
+61-クリスマス島
+61-ココス諸島
+57-コロンビア
+269-コモロ
+243-コンゴ民主共和国
+242-コンゴ共和国
+682-クック諸島
+506-コスタリカ
+225-コートジボワール
+385-クロアチア
+53-キューバ
+357-キプロス
+420-チェコ
+45-デンマーク
+253-ジブチ
+1-ドミニカ
+1-ドミニカ共和国
+593-エクアドル
+20-エジプト
+503-エルサルバドル
+240-赤道ギニア
+291-エリトリア
+372-エストニア
+268-エスワティニ
+251-エチオピア
+500-フォークランド諸島
+298-フェロー諸島
+679-フィジー
+358-フィンランド
+33-フランス
+594-フランス領ギアナ
+689-フランス領ポリネシア
+241-ガボン
+220-ガンビア
+995-ジョージア
+49-ドイツ
+233-ガーナ
+350-ジブラルタル
+30-ギリシャ
+299-グリーンランド
+1-グレナダ
+590-グアドループ
+1-グアム
+502-グアテマラ
+224-ギニア
+245-ギニアビサウ
+592-ガイアナ
+509-ハイチ
+504-ホンジュラス
+852-香港
+36-ハンガリー
+354-アイスランド
+91-インド
+62-インドネシア
+98-イラン
+964-イラク
+353-アイルランド
+972-イスラエル
+39-イタリア
+1-ジャマイカ
+81-日本
+962-ヨルダン
+7-カザフスタン
+254-ケニア
+686-キリバス
+850-北朝鮮
+82-韓国
+965-クウェート
+996-キルギス
+856-ラオス
+371-ラトビア
+961-レバノン
+266-レソト
+231-リベリア
+218-リビア
+423-リヒテンシュタイン
+370-リトアニア
+352-ルクセンブルク
+853-マカオ
+261-マダガスカル
+265-マラウイ
+60-マレーシア
+960-モルディブ
+223-マリ
+356-マルタ
+692-マーシャル諸島
+596-マルティニーク
+222-モーリタニア
+230-モーリシャス
+262-マヨット
+52-メキシコ
+691-ミクロネシア
+373-モルドバ
+377-モナコ
+976-モンゴル
+382-モンテネグロ
+1-モントセラト
+212-モロッコ
+258-モザンビク
+95-ミャンマー
+264-ナミビア
+674-ナウル
+977-ネパール
+31-オランダ
+687-ニューカレドニア
+64-ニュージーランド
+505-ニカラグア
+227-ニジェール
+234-ナイジェリア
+683-ニウエ
+672-ノーフォーク島
+389-北マケドニア
+1-北マリアナ諸島
+47-ノルウェー
+968-オマーン
+92-パキスタン
+680-パラオ
+970-パレスチナ
+507-パナマ
+675-パプアニューギニア
+595-パラグアイ
+51-ペルー
+63-フィリピン
+48-ポーランド
+351-ポルトガル
+1-プエルトリコ
+974-カタール
+262-レユニオン
+40-ルーマニア
+7-ロシア
+250-ルワンダ
+590-サン・バルテルミー
+290-セントヘレナ
+1-セントクリストファー・ネイビス
+1-セントルシア
+590-サン・マルタン
+508-サンピエール島・ミクロン島
+1-セントビンセント・グレナディーン
+685-サモア
+378-サンマリノ
+239-サントメ・プリンシペ
+966-サウジアラビア
+221-セネガル
+381-セルビア
+248-セーシェル
+232-シエラレオネ
+65-シンガポール
+1-シント・マールテン
+421-スロバキア
+386-スロベニア
+677-ソロモン諸島
+252-ソマリア
+27-南アフリカ
+211-南スーダン
+34-スペイン
+94-スリランカ
+249-スーダン
+597-スリナム
+46-スウェーデン
+41-スイス
+963-シリア
+886-台湾
+992-タジキスタン
+255-タンザニア
+66-タイ
+670-東ティモール
+228-トーゴ
+690-トケラウ
+676-トンガ
+1-トリニダード・トバゴ
+216-チュニジア
+90-トルコ
+993-トルクメニスタン
+1-タークス・カイコス諸島
+688-ツバル
+256-ウガンダ
+380-ウクライナ
+971-アラブ首長国連邦
+44-イギリス
+1-アメリカ合衆国
+598-ウルグアイ
+998-ウズベキスタン
+678-バヌアツ
+58-ベネズエラ
+84-ベトナム
+1-英領ヴァージン諸島
+1-米領ヴァージン諸島
+681-ウォリス・フツナ
+967-イエメン
+260-ザンビア
+263-ジンバブエ
No data
製品
LynxPDF
法人向け
Windows版 LynxPDF
Mac版 LynxPDF
iOS版LynxPDF
新規
LynxPDF for Android
新規
LynxPDF Web
管理コンソール
オンラインツール
PDFをWordへ
PDFをExcelへ
PDFをPPTへ
PDFを画像へ
PDF結合
PDF圧縮
PDF編集
OCR PDF
PDF一括Word変換
PDF一括圧縮
すべてのツール
機能
PDFを編集
PDFを変換
PDFに注釈
PDFに署名
フォーム入力
PDF比較
墨消し
新規
PDFを保護
PDFを閲覧
PDF OCR
PDFを整理
PDF を分割
新規
PDF のテキスト読み上げ
新規
すべての機能
ソリューション
ソリューション
教育
建設
製造
ITサービス
ヘルスケア
ファイナンス
物流
法務サービス
人事
調達
コンサルティングサービス
小売・Eコマース
不動産
会計チーム
営業チーム
政府・公共部門
法務チーム
保険・保険金請求
米国非営利団体
リソース
リソース
FAQ
ブログ
ホワイトペーパー
新規
導入事例
会社情報
お問い合わせ
GDPR
比較
価格
パートナー
営業担当者へのお問い合わせ
無料ダウンロード
ログイン
English (U.S.)
English (Australia)
English (Canada)
English (U.K.)
Français
Français (Canada)
Español (México)
Español
العربية
Русский язык
中文 (简体)
中文 (繁體)
Português (Brasil)
Português (Portugal)
Deutsch
हिन्दी
Bahasa Indonesia
Bahasa Melayu
日本語 (にほんご)
Italiano
Nederlands
Türkçe
Polski
Українська
Svenska
Ελληνικά
ภาษาไทย (Phasa Thai)
Tiếng Việt
한국어
Română
Čeština
Magyar
Suomi
עברית
Norsk
Dansk
Slovenčina
Hrvatski
Català
English (U.S.)
English (Australia)
English (Canada)
English (U.K.)
Français
Français (Canada)
Español (México)
Español
العربية
Русский язык
中文 (简体)
中文 (繁體)
Português (Brasil)
Português (Portugal)
Deutsch
हिन्दी
Bahasa Indonesia
Bahasa Melayu
日本語 (にほんご)
Italiano
Nederlands
Türkçe
Polski
Українська
Svenska
Ελληνικά
ภาษาไทย (Phasa Thai)
Tiếng Việt
한국어
Română
Čeština
Magyar
Suomi
עברית
Norsk
Dansk
Slovenčina
Hrvatski
Català
製品
LynxPDF
法人向け
Windows版 LynxPDF
Mac版 LynxPDF
iOS版LynxPDF
新規
LynxPDF for Android
新規
LynxPDF Web
管理コンソール
オンラインツール
PDFをWordへ
PDFをExcelへ
PDFをPPTへ
PDFを画像へ
PDF結合
PDF圧縮
PDF編集
OCR PDF
PDF一括Word変換
PDF一括圧縮
すべてのツール
機能
PDFを編集
PDFを変換
PDFに注釈
PDFに署名
フォーム入力
PDF比較
墨消し
新規
PDFを保護
PDFを閲覧
PDF OCR
PDFを整理
PDF を分割
新規
PDF のテキスト読み上げ
新規
すべての機能
ソリューション
教育
建設
製造
ITサービス
ヘルスケア
ファイナンス
物流
法務サービス
人事
調達
コンサルティングサービス
小売・Eコマース
不動産
会計チーム
営業チーム
政府・公共部門
法務チーム
保険・保険金請求
米国非営利団体
リソース
FAQ
ブログ
ホワイトペーパー
新規
導入事例
会社情報
お問い合わせ
GDPR
比較
価格
パートナー
営業担当者へのお問い合わせ
ログイン
無料ダウンロード
PDFページ全体をコピーせずに
テキスト
を抽出する
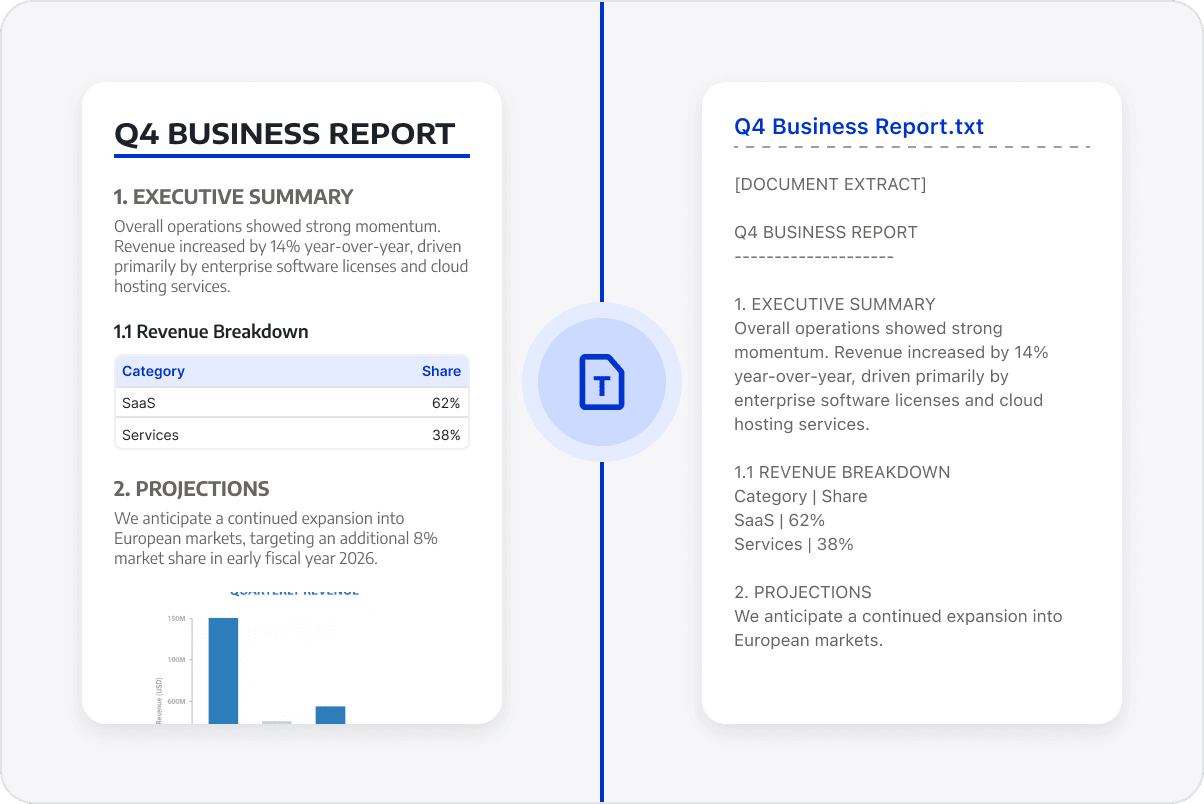
PDFからテキストを抽出してTXT形式に変換することで、編集、レビュー、コンテンツの整理、ナレッジの蓄積が容易になります。
営業チームにお問い合わせ
無料トライアル
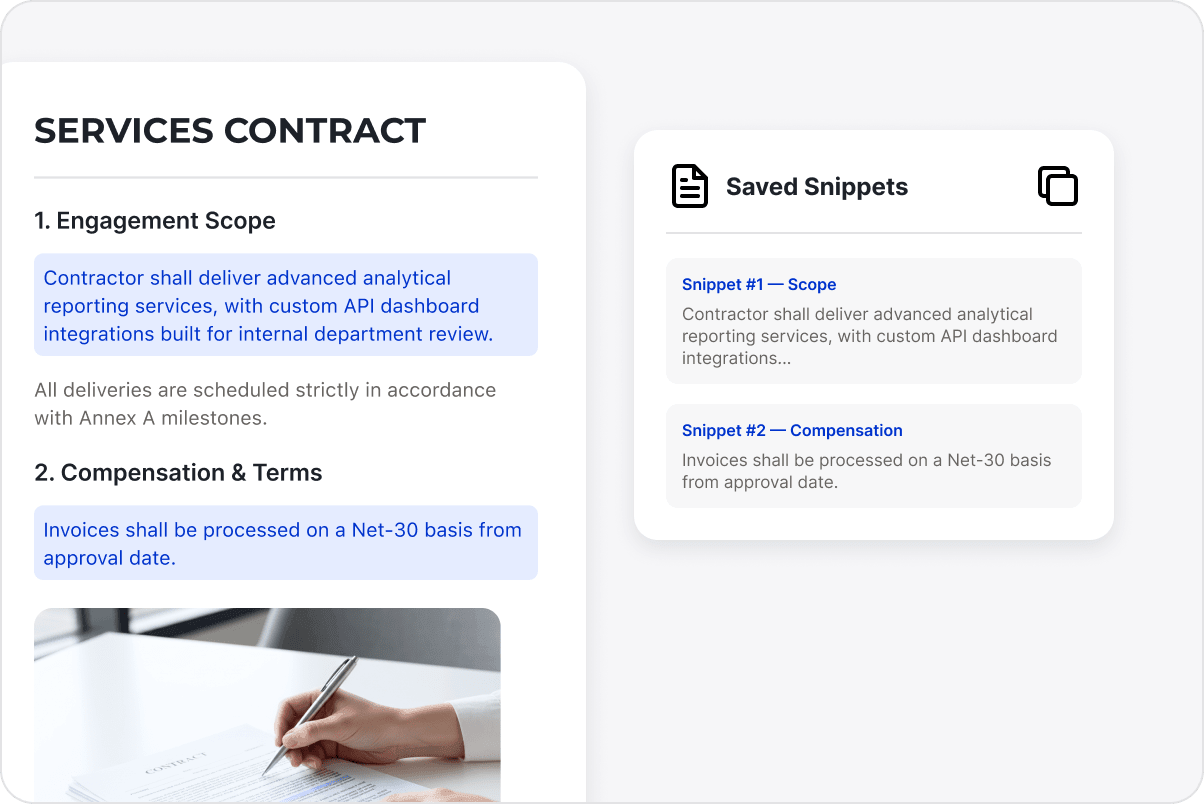
PDFテキストを抽出する
レポート、契約書、長文文書から検索可能なテキストを抽出して、手動でのコピーやページごとの整理作業を減らし、編集、引用、分析に活用できるようにします。
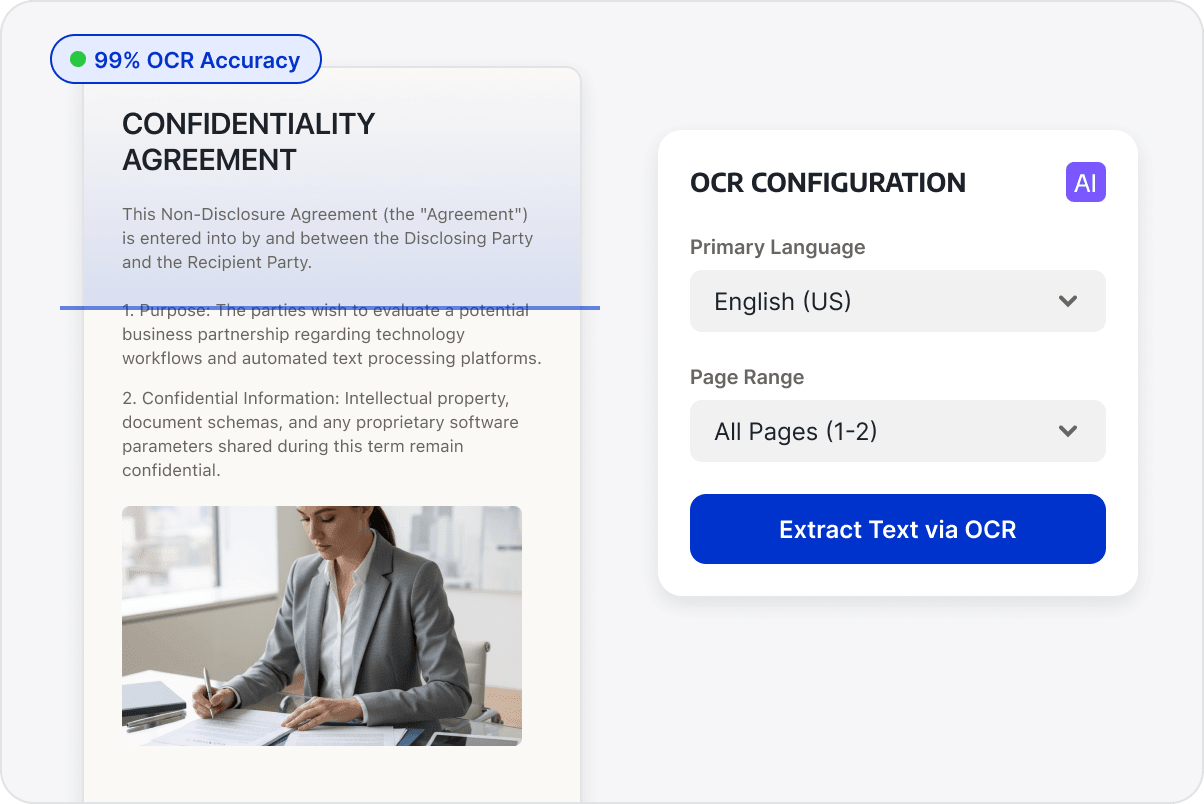
スキャンされたコンテンツからテキストを抽出する
スキャンされたページを含むPDFは、OCRを使用してテキストを認識することで、直接コピーできないデータも、その後の処理に活用できます。
抽出したテキストを再利用
元の文書の読み順に従ってテキストを整理し、タイトル、段落、本文の関係を可能な限り維持し、その後の並べ替えの負担を軽減します。
抽出後のデータ活用も簡単
抽出したテキストを、メモやデータ整理、コンテンツレビュー、社内ナレッジの蓄積などに活用することで、コンテンツを検索してコピーするために PDF を繰り返し開く必要性が減ります。
抽出テキストを引き続き使用する
抽出されたテキストは、メモ、コンテンツのレビュー、データの整理、知識の蓄積に引き続き使用できるため、コンテンツを見つけるために PDFを繰り返し開く手間を軽減できます。
LynxPDF Expert ライブラリにアクセス
企業文書管理のための先進的な洞察と戦略的ガイド。
すべてのホワイトペーパーを見る
すべてのホワイトペーパーを見る
さらに多くのビジネス向け機能を探る
編集
フォーム&署名
セキュア
注釈
OCR
閲覧
チュートリアルと人気記事をチェック
初心者向けガイド
Which File Formats Can I Convert Using LynxPDF?
How to activate LynxPDF through License Code?
LynxPDF vs Kofax Power PDF
Why LynxPDF is the Best Adobe Acrobat Alternative for Enterprise Use?
How about LynxPDF’s OCR, and What are Its Main Advantages?
Does LynxPDF Support Batch Processing?
Does LynxPDF Support Digital Signatures?
Does LynxPDF Support Web, Mobile, and Team Collaboration?
FAQをもっと見る
注目の人気記事
ABBYY FineReader PDF Alternative: Enterprise PDF Management Comparison
Thu. 27 Aug. 2026
Sejda vs LynxPDF: Linux Flexibility or Managed PDF Operations?
Wed. 26 Aug. 2026
Smallpdf vs LynxPDF: When PDF Work Needs More Control
Wed. 26 Aug. 2026
記事をもっと見る
営業チームに
お問い合わせ
LynxPDF に関するあらゆるご質問にお答えします。下記のフォームにご記入いただければ、営業担当が折り返し連絡いたします。
LynxPDFおよびLynxPDF管理コンソールの14日間無料体験を開始。
チームに最適な料金プランを選択してください。
あなたのチームに適したアプリケーションシナリオを検討します。
最大50%のボリューム割引を獲得
ビジネスメール
名前
会社サイト
国/地域
選択してください
電話番号
選択してください
-
ご要望をお聞かせください
0 / 1000