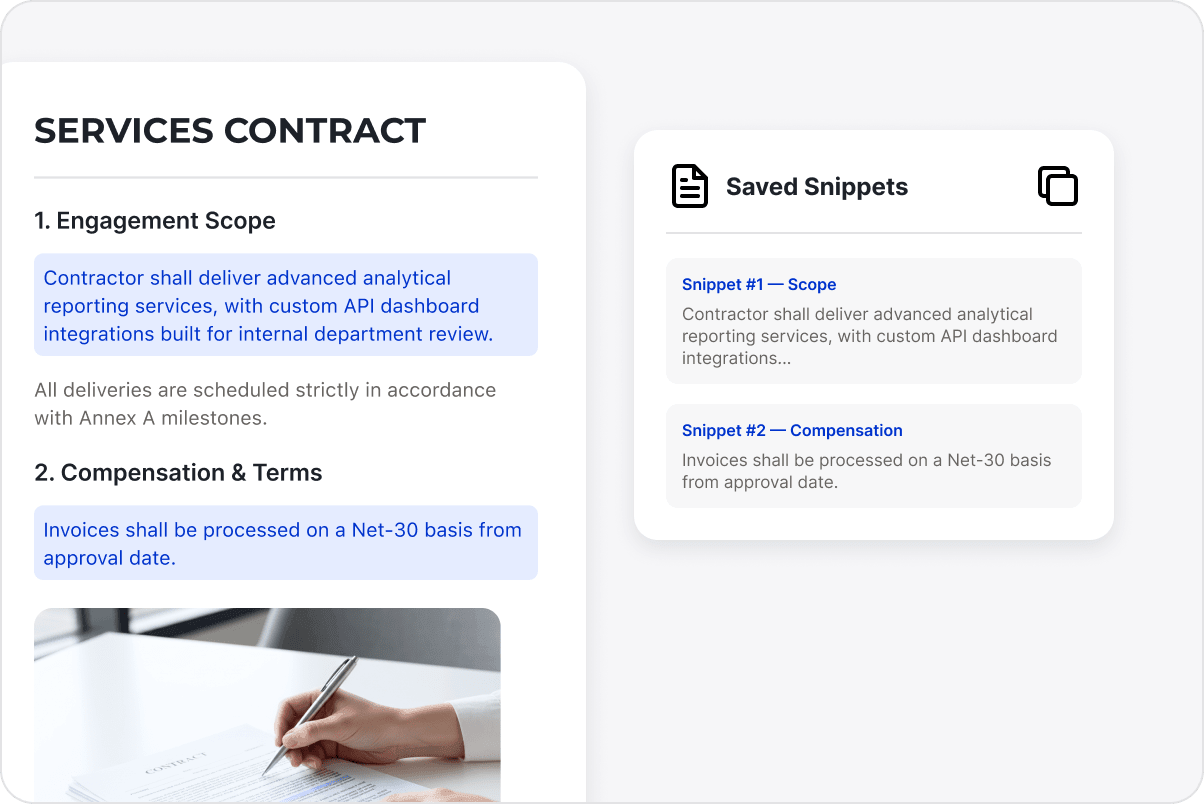
Extrahujte prohledávatelný text ze zpráv, smluv a dlouhých dokumentů, abyste omezili ruční kopírování a organizaci po stránkách, což usnadňuje úpravy, odkazování a analýzu.
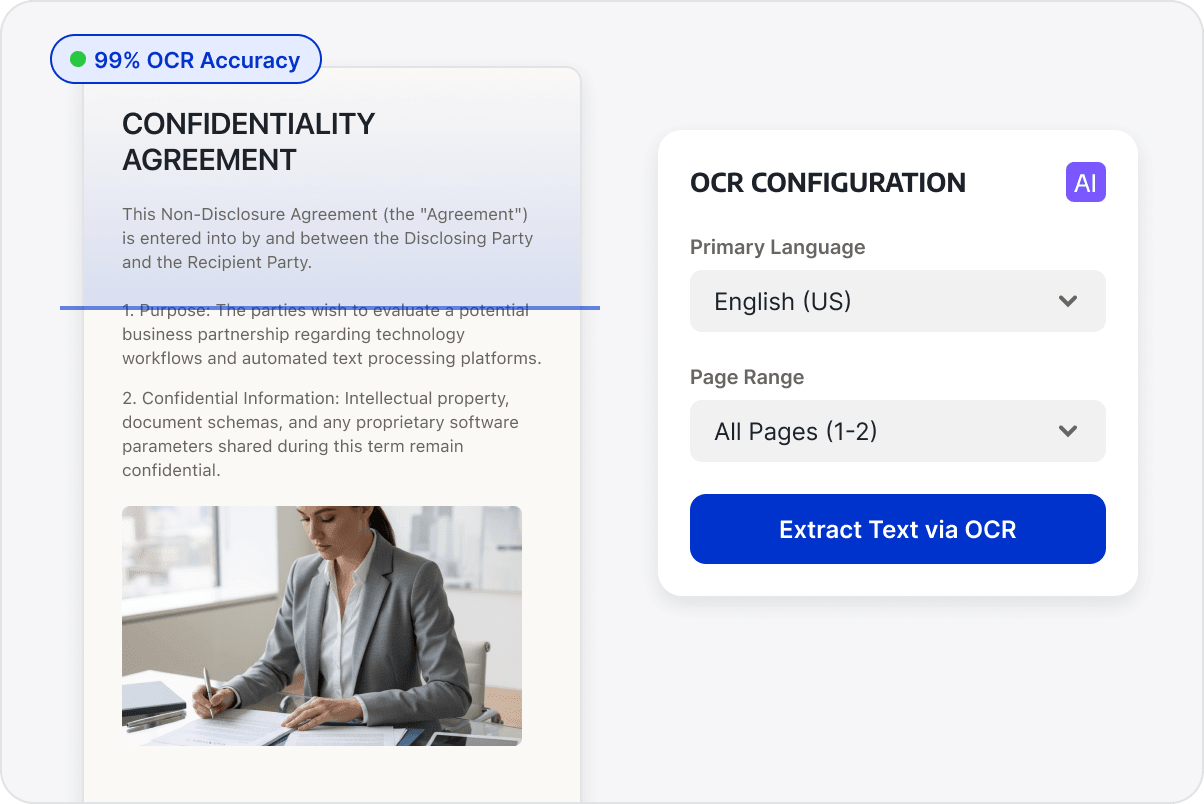
Rozpoznávání textu v naskenovaných PDF souborech
Použijte OCR k rozpoznání textu na naskenovaných stránkách a v PDF souborech založených na obrázcích před extrakcí.
Znovu použít extrahovaný text
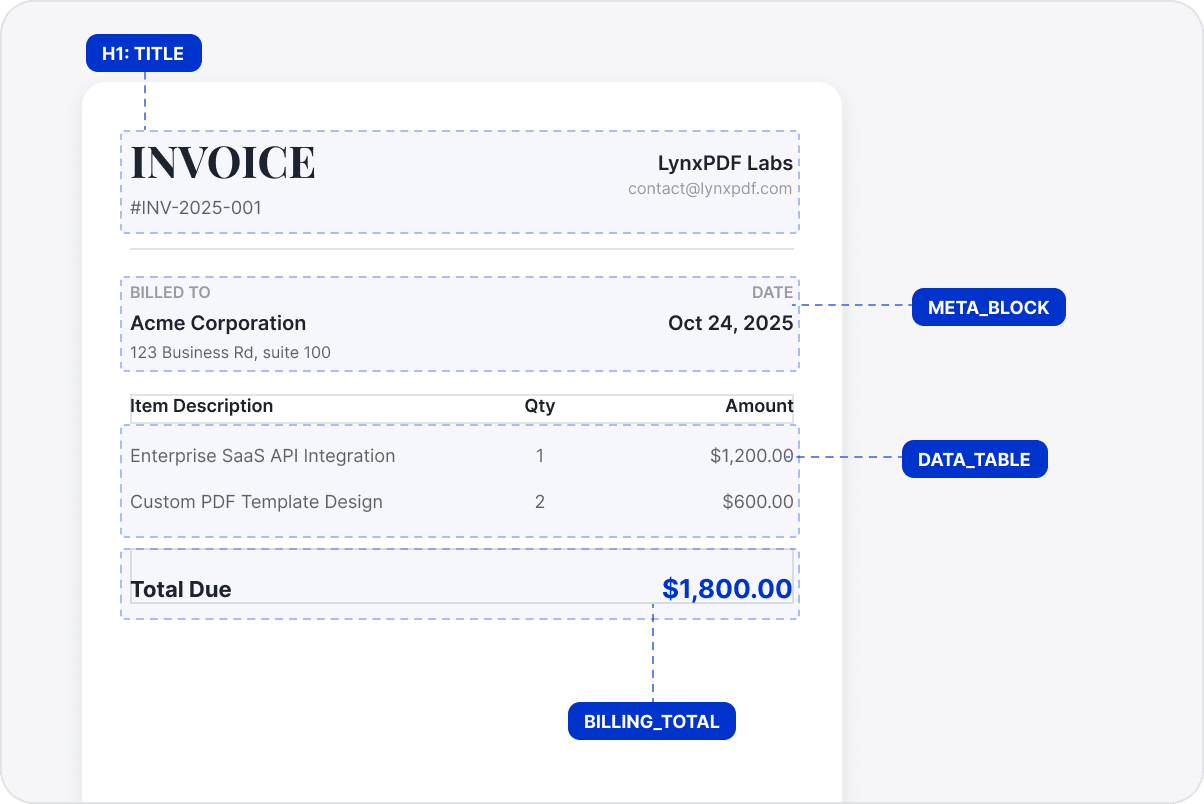
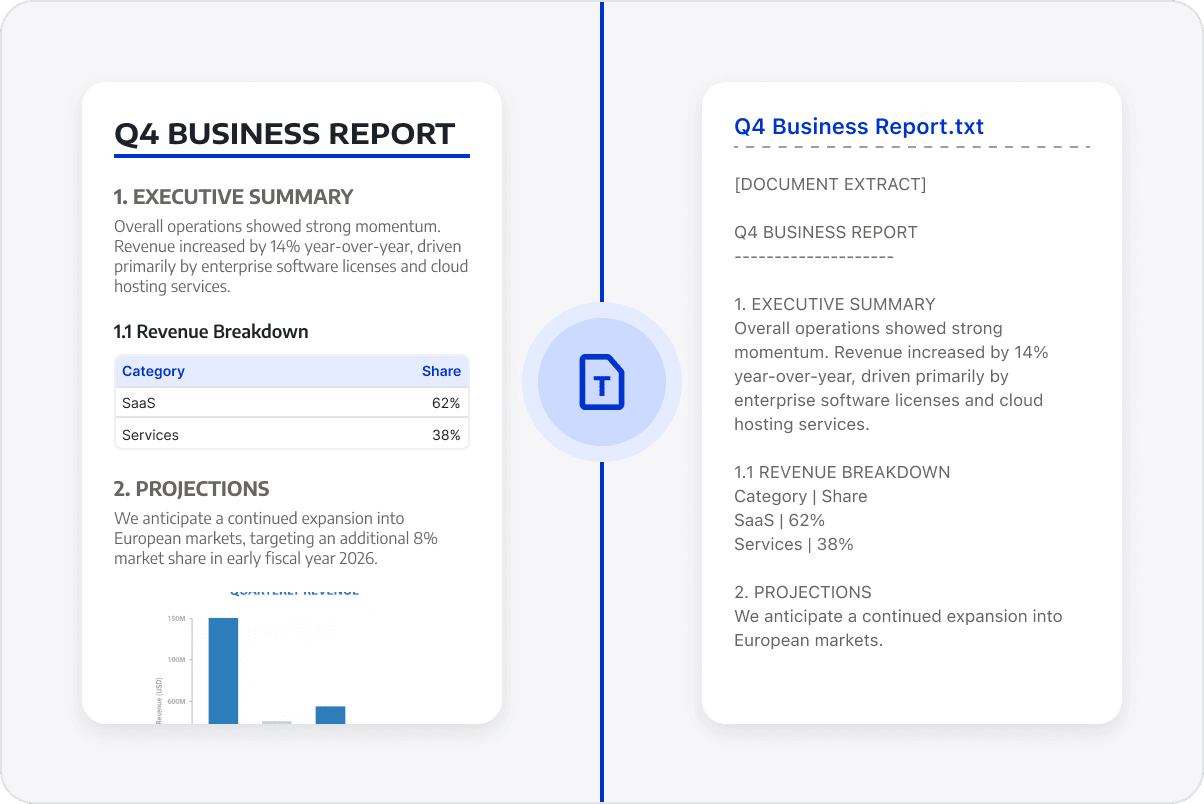
Uspořádejte extrahovaný text v původním pořadí čtení a pokud možno zachovejte nadpisy, odstavce a klíčové vztahy mezi obsahem, abyste omezili nutnost přeformátování.
Pokračovat v práci s extrahovaným textem
Používejte extrahovaný text pro poznámky, organizaci dat, kontrolu obsahu nebo interní zachycení znalostí, čímž snižujete potřebu znovu otevírat PDF soubory pro vyhledání a kopírování obsahu.
Pokračovat v používání extrahovaného textu
I nadále používejte extrahovaný text pro poznámky, kontrolu obsahu, organizaci dat a zachycování znalostí, čímž se sníží počet opakovaných vyhledávání v PDF.
Přístup do knihovny expertů LynxPDF
Perspektivní poznatky a strategické průvodce pro správu podnikových dokumentů.