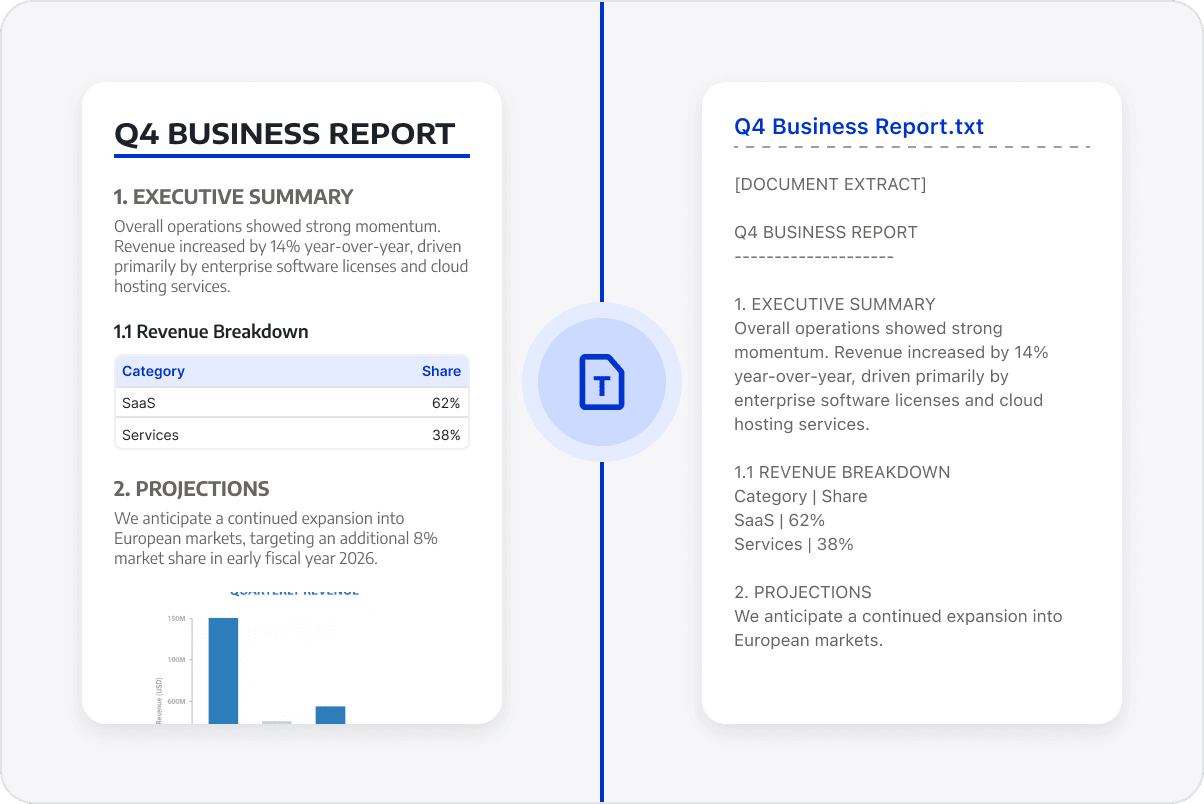
Extrahieren Sie durchsuchbaren Text aus Berichten, Verträgen und langen Dokumenten, um manuelles Kopieren und seitenweises Organisieren zu reduzieren und so die Bearbeitung, das Nachschlagen und die Analyse zu vereinfachen.
Texterkennung in gescannten PDFs
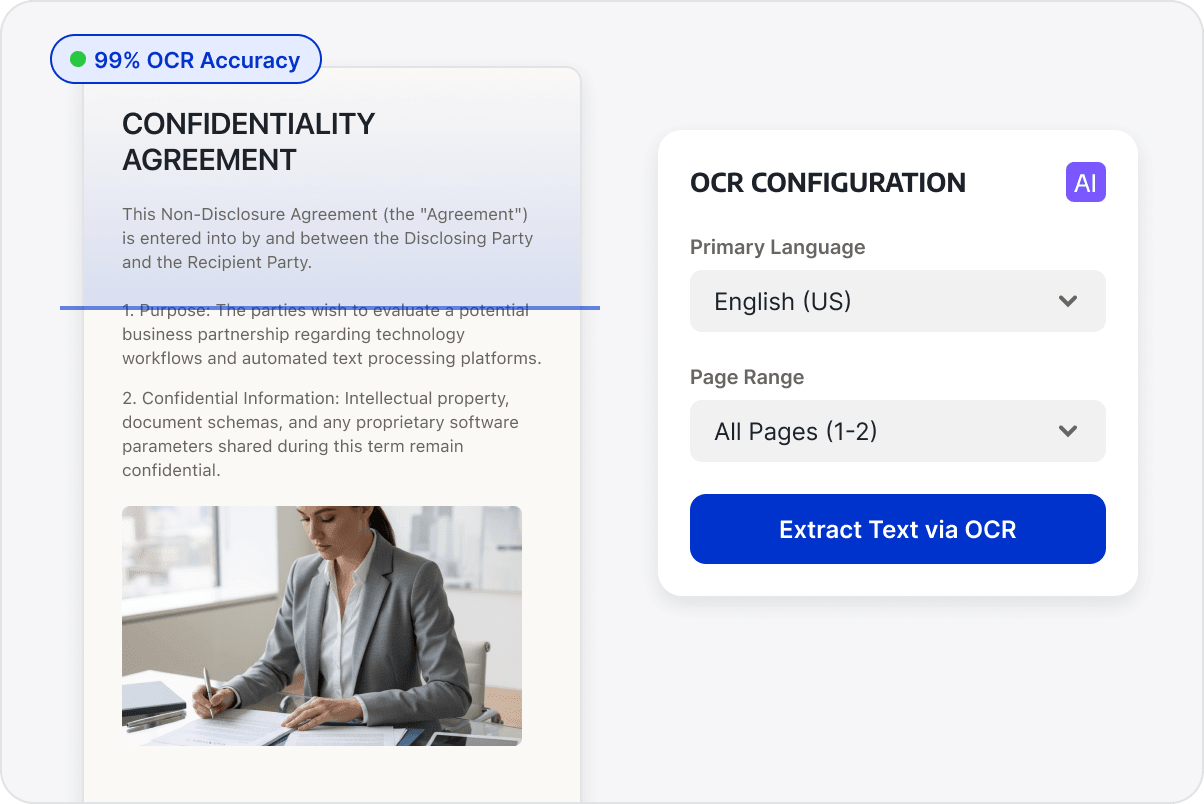
Verwenden Sie OCR, um Text in gescannten Seiten und bildbasierten PDFs vor der Extraktion zu erkennen.
Extrahierten Text wiederverwenden
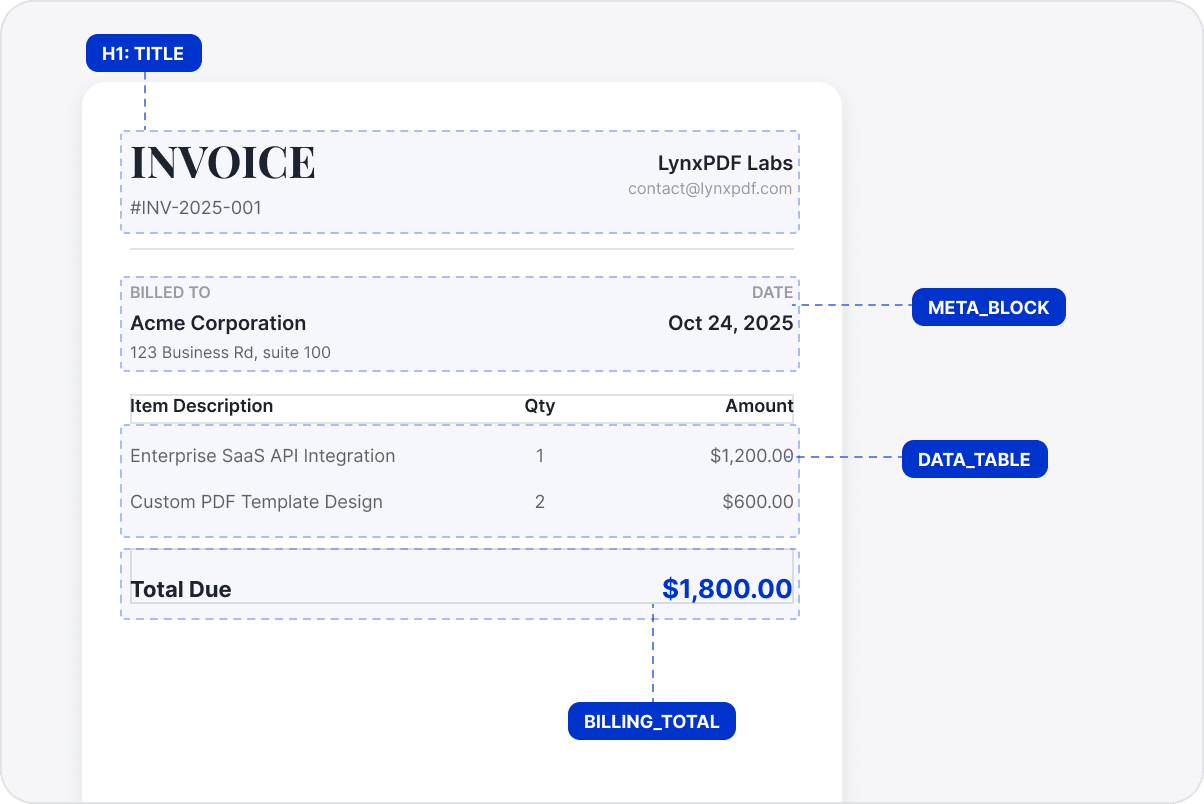
Ordnen Sie den extrahierten Text in der ursprünglichen Lesereihenfolge an und erhalten Sie nach Möglichkeit Überschriften, Absätze und wichtige Inhaltsbeziehungen bei, um den Formatierungsaufwand zu reduzieren.
Weiterarbeit mit dem extrahierten Text
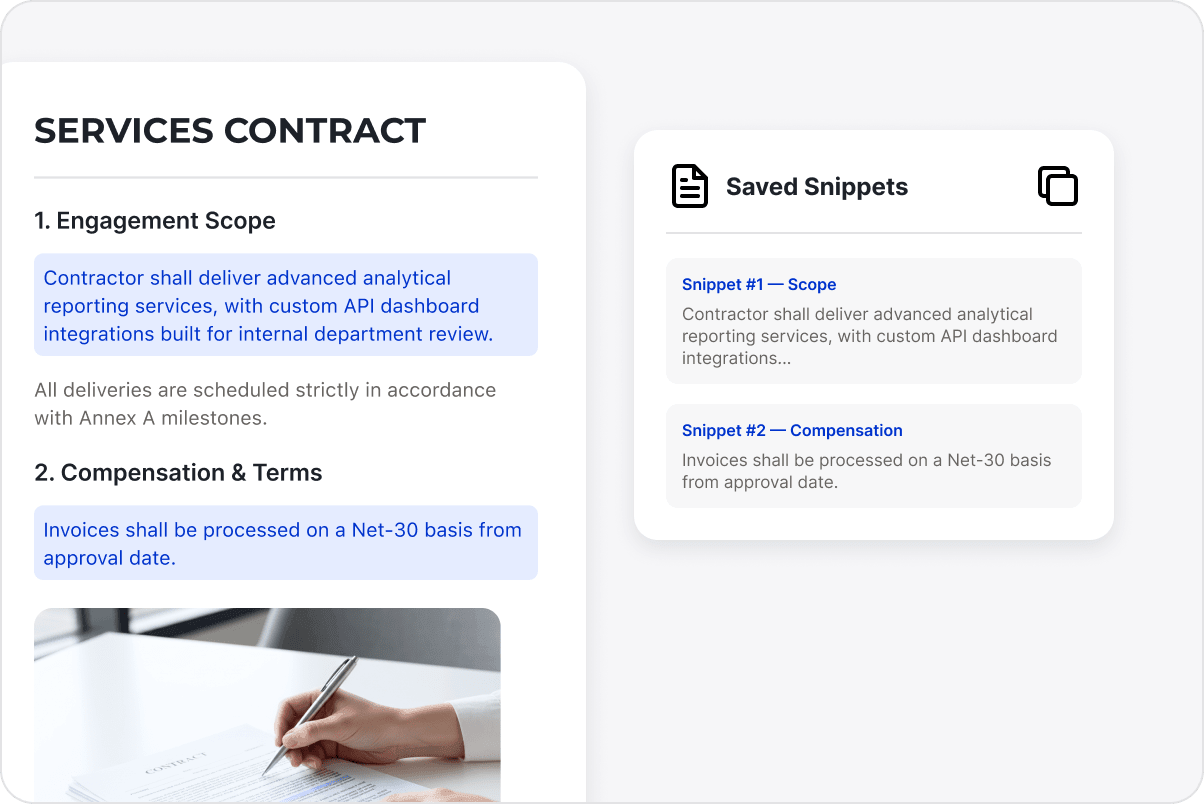
Nutzen Sie den extrahierten Text für Notizen, Datenorganisation, Inhaltsprüfung oder interne Wissenserfassung, wodurch die Notwendigkeit, PDFs erneut zu öffnen, um Inhalte zu finden und zu kopieren, reduziert wird.
Verwenden Sie weiterhin den extrahierten Text.
Nutzen Sie den extrahierten Text weiterhin für Notizen, Inhaltsprüfung, Datenorganisation und Wissenserfassung, um wiederholte Suchvorgänge in der PDF-Datei zu vermeiden.
Zugang zur LynxPDF-Expertenbibliothek
Zukunftsweisende Einblicke und strategische Leitfäden für das Dokumentenmanagement in Unternehmen.
Gerne beantworten wir alle Ihre Fragen zu LynxPDF. Füllen Sie einfach das folgende Formular aus, und ein Vertriebsmitarbeiter wird sich in Kürze mit Ihnen in Verbindung setzen:
Starten Sie Ihre 14-tägige Testphase von LynxPDF und der LynxPDF Administrationskonsole.
Wählen Sie das optimale Preismodell für Ihr Team.
Entdecken Sie Einsatzszenarien und Fallstudien, die für Ihr Unternehmen relevant sind.