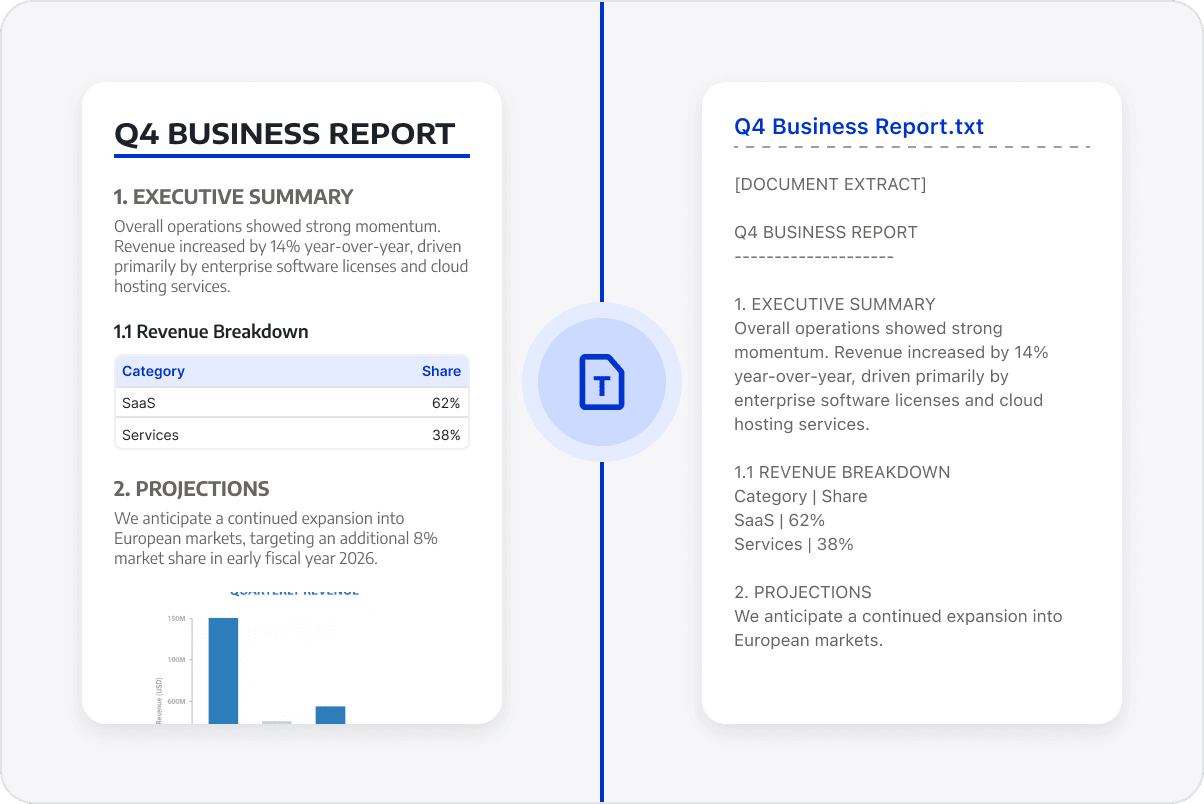
Витягуйте текст, у якому можна шукати, зі звітів, договорів та довгих документів, щоб зменшити ручне копіювання та посторінкову організацію, що полегшує редагування, посилання та аналіз.
Розпізнавання тексту у відсканованих PDF-файлах
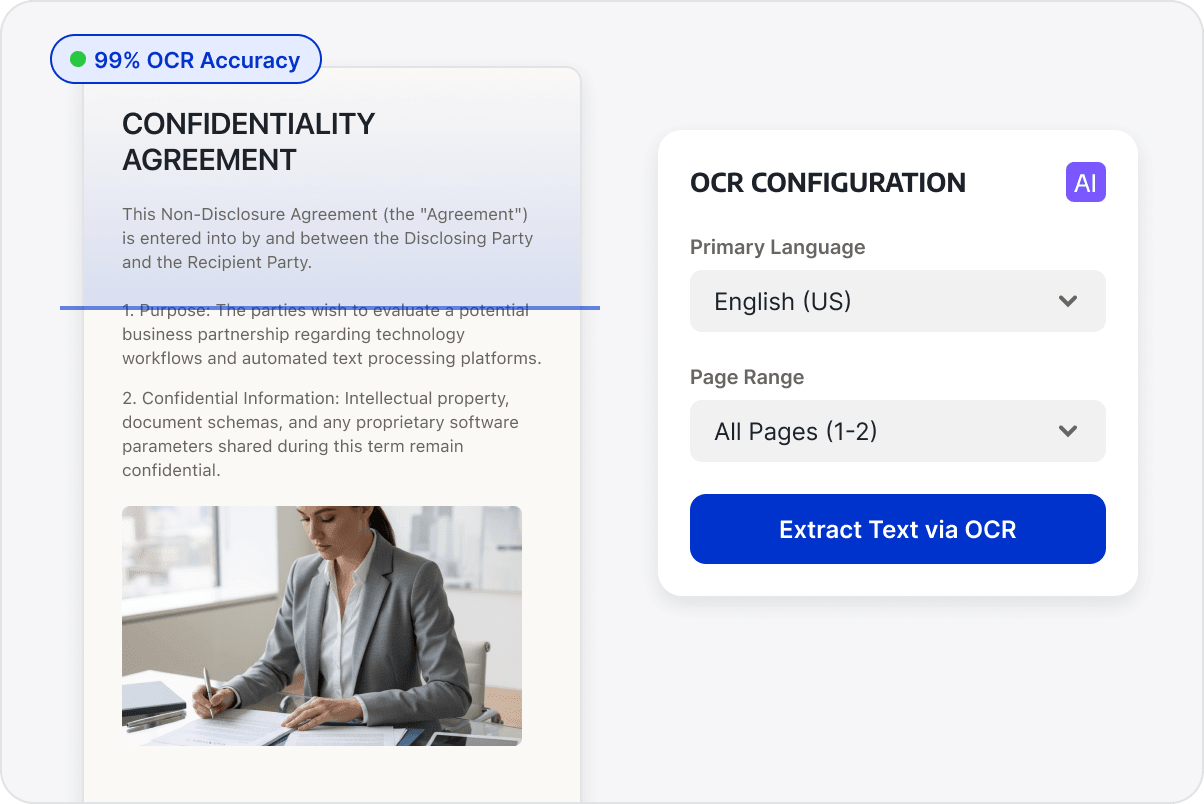
Використовуйте OCR для розпізнавання тексту на відсканованих сторінках та PDF-файлах на основі зображень перед вилученням.
Повторне використання видобутого тексту
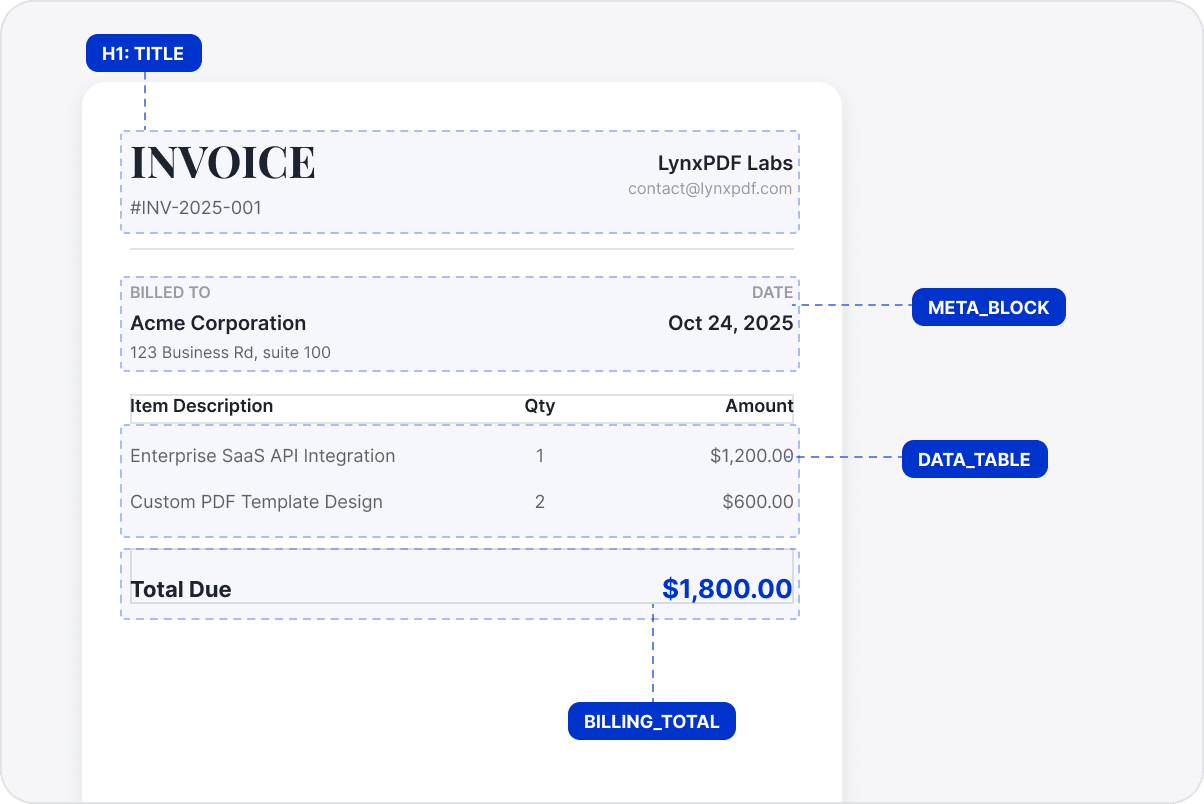
Упорядкуйте витягнутий текст у вихідному порядку читання та збережіть заголовки, абзаци та ключові зв'язки між вмістом, де це можливо, щоб зменшити потребу в переформатуванні.
Продовжити роботу з витягнутим текстом
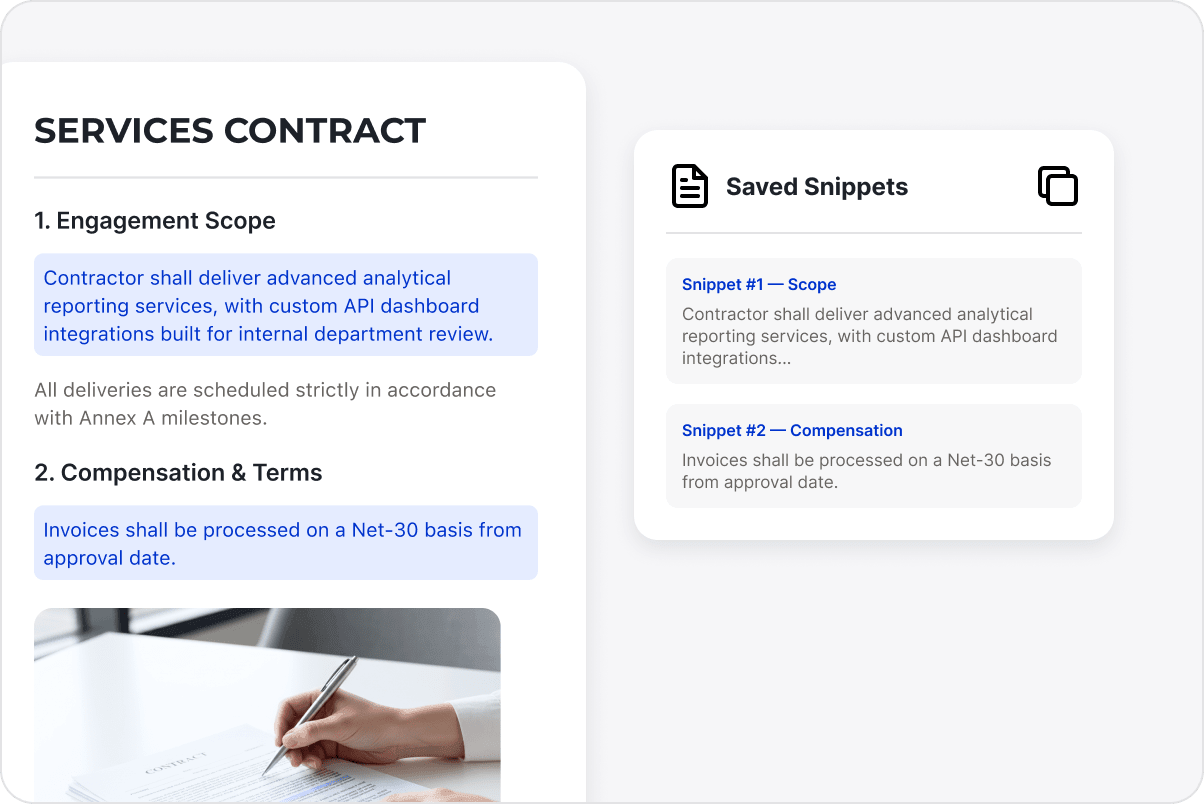
Використовуйте видобутий текст для нотаток, упорядкування даних, перегляду контенту або внутрішнього збору знань, що зменшує потребу повторно відкривати PDF-файли для пошуку та копіювання контенту.
Продовжити використання витягнутого тексту
Продовжуйте використовувати видобутий текст для нотаток, перегляду контенту, організації даних та збору знань, зменшуючи кількість повторних пошуків у PDF-файлі.
Доступ до експертної бібліотеки LynxPDF
Перспективні аналітичні матеріали та стратегічні посібники з управління корпоративними документами.