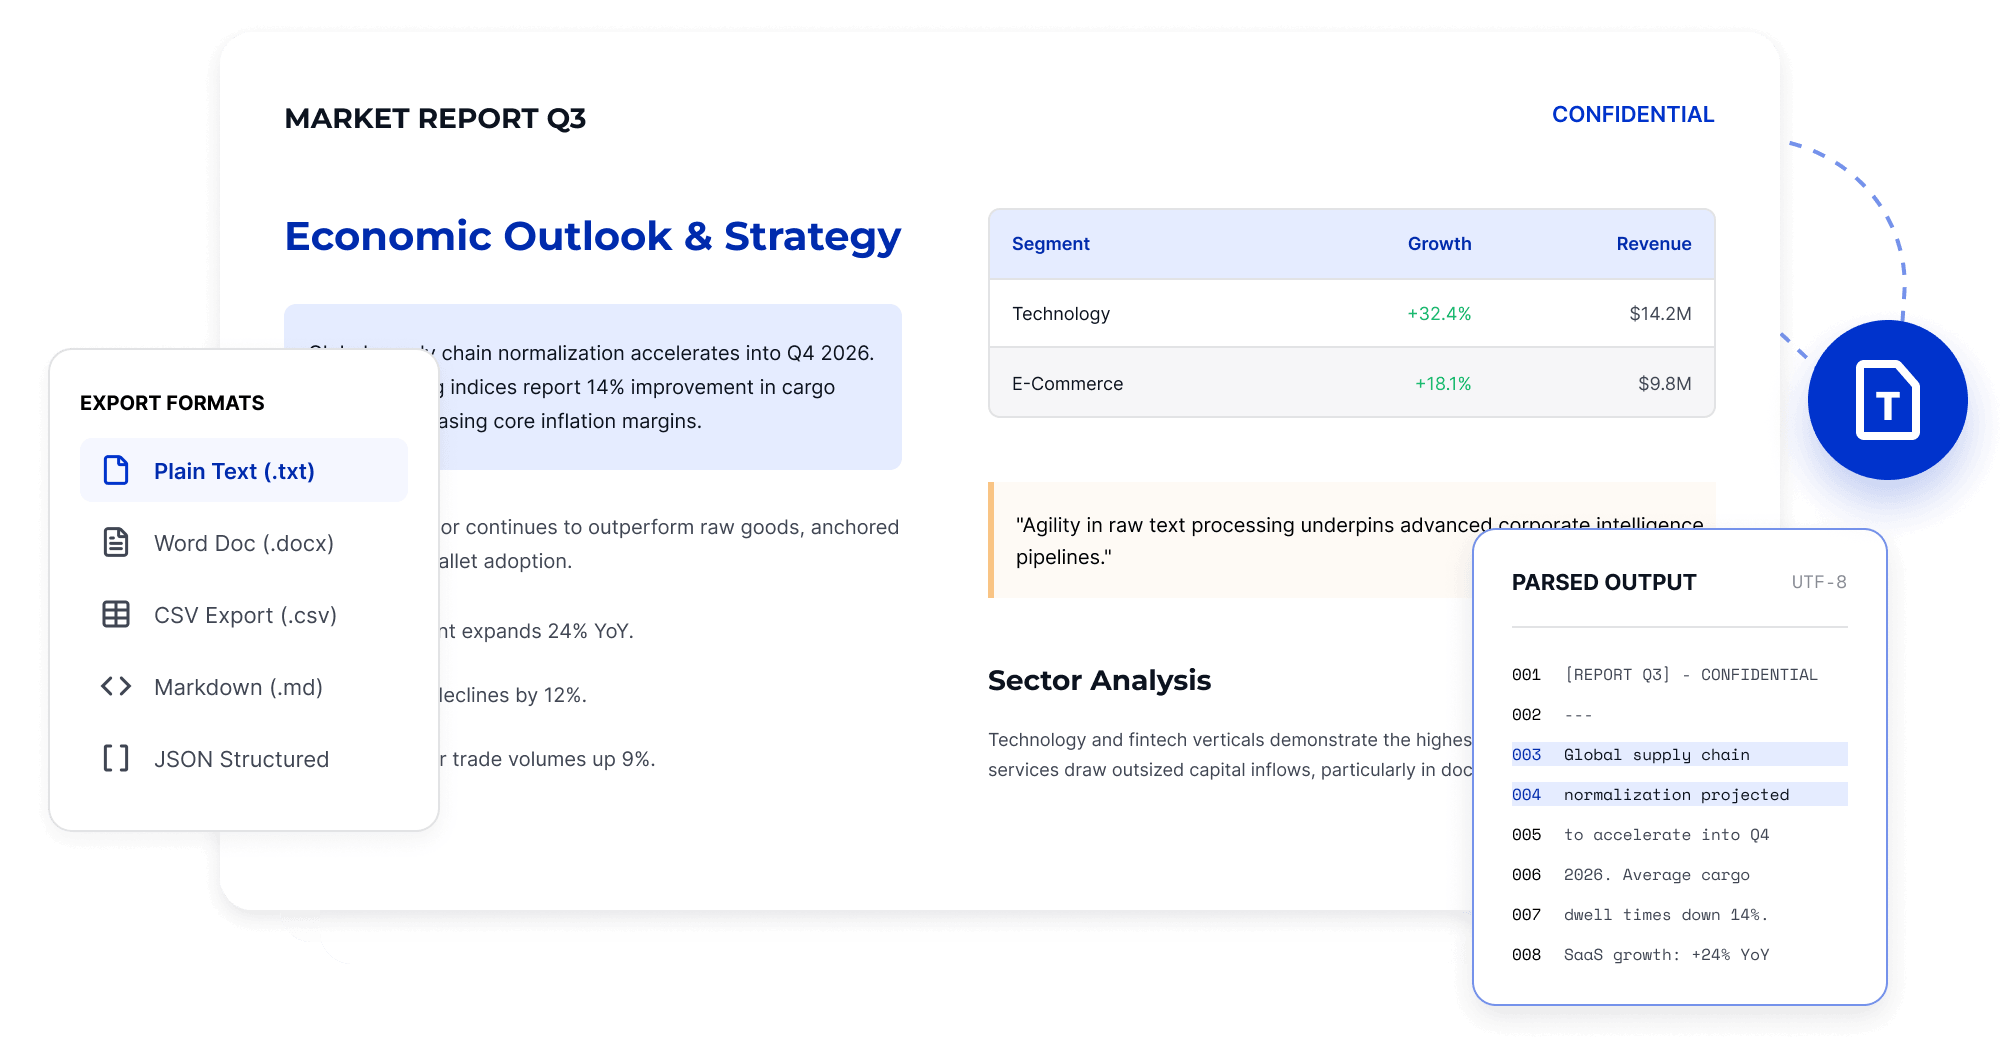
रिपोर्टों, अनुबंधों और लंबे दस्तावेजों से खोज योग्य पाठ निकालें ताकि मैन्युअल प्रतिलिपि बनाने और पृष्ठ-दर-पृष्ठ व्यवस्थित करने की आवश्यकता कम हो जाए, जिससे संपादन, संदर्भ और विश्लेषण करना आसान हो जाए।
स्कैन किए गए PDF में टेक्स्ट को पहचानें
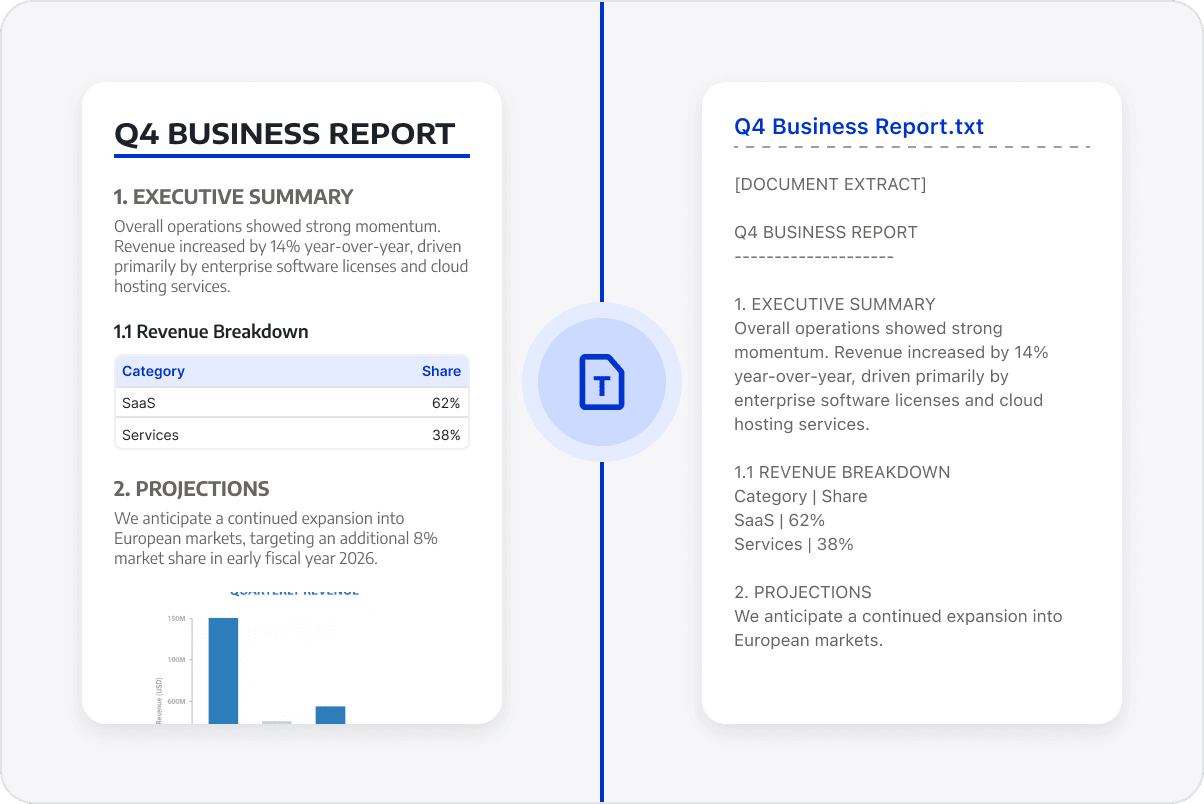
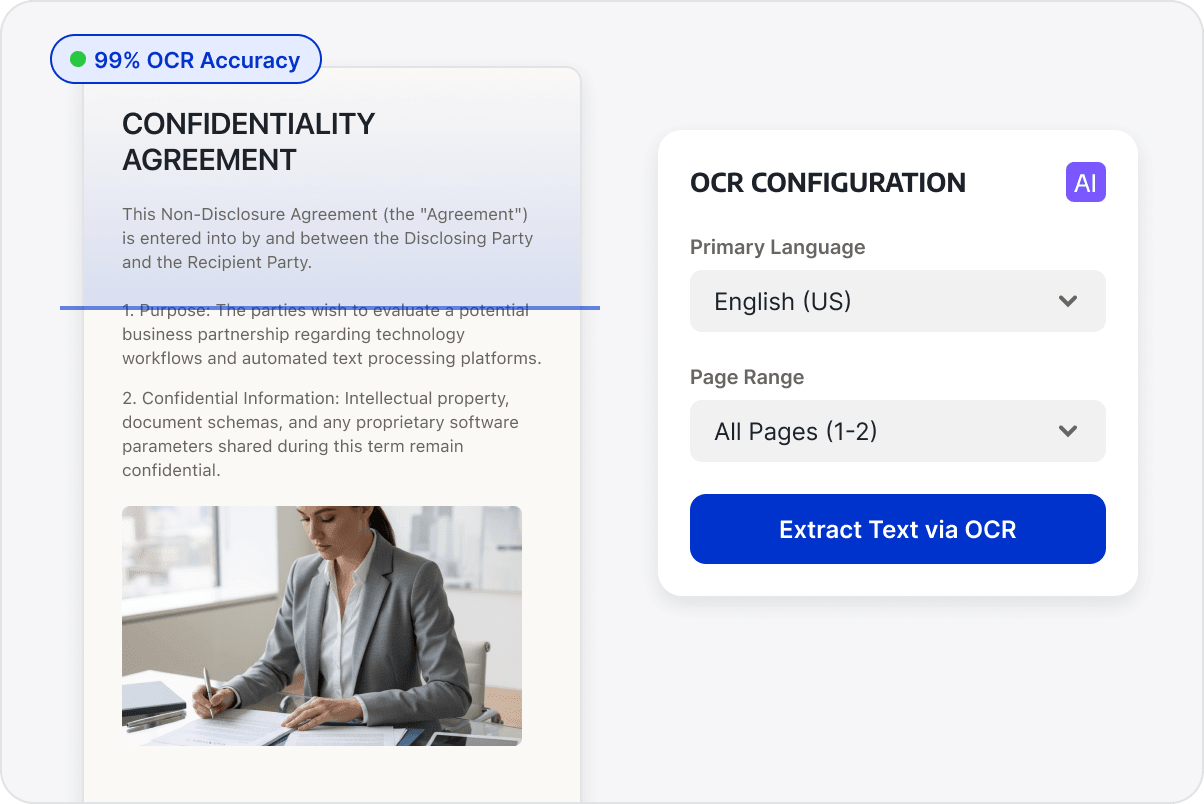
एक्सट्रैक्शन से पहले स्कैन किए गए पेजों और इमेज-आधारित PDF में टेक्स्ट को पहचानने के लिए OCR का उपयोग करें।
निकाले गए पाठ का पुनः उपयोग करें
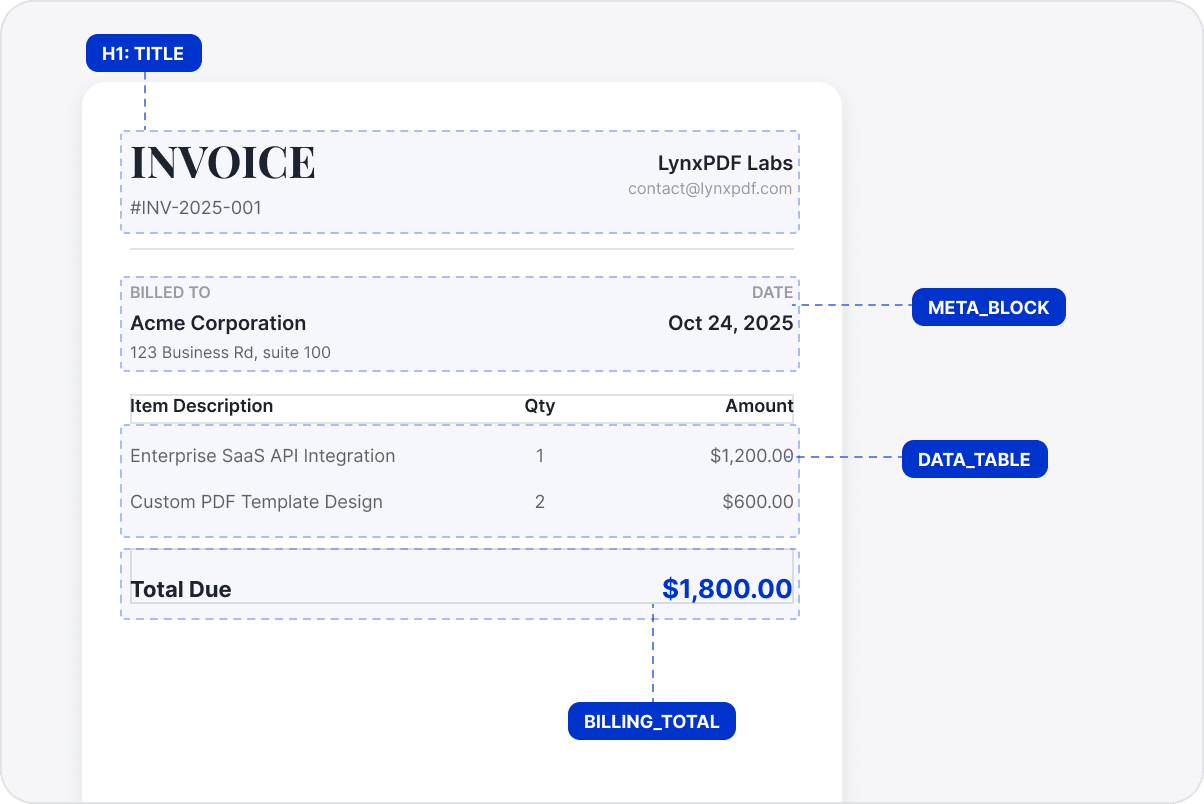
निकाले गए पाठ को मूल पठन क्रम में व्यवस्थित करें और जहां संभव हो, शीर्षकों, अनुच्छेदों और प्रमुख विषयवस्तु संबंधों को संरक्षित रखें ताकि पुनः स्वरूपण को कम किया जा सके।
निकाले गए पाठ के साथ काम करना जारी रखें
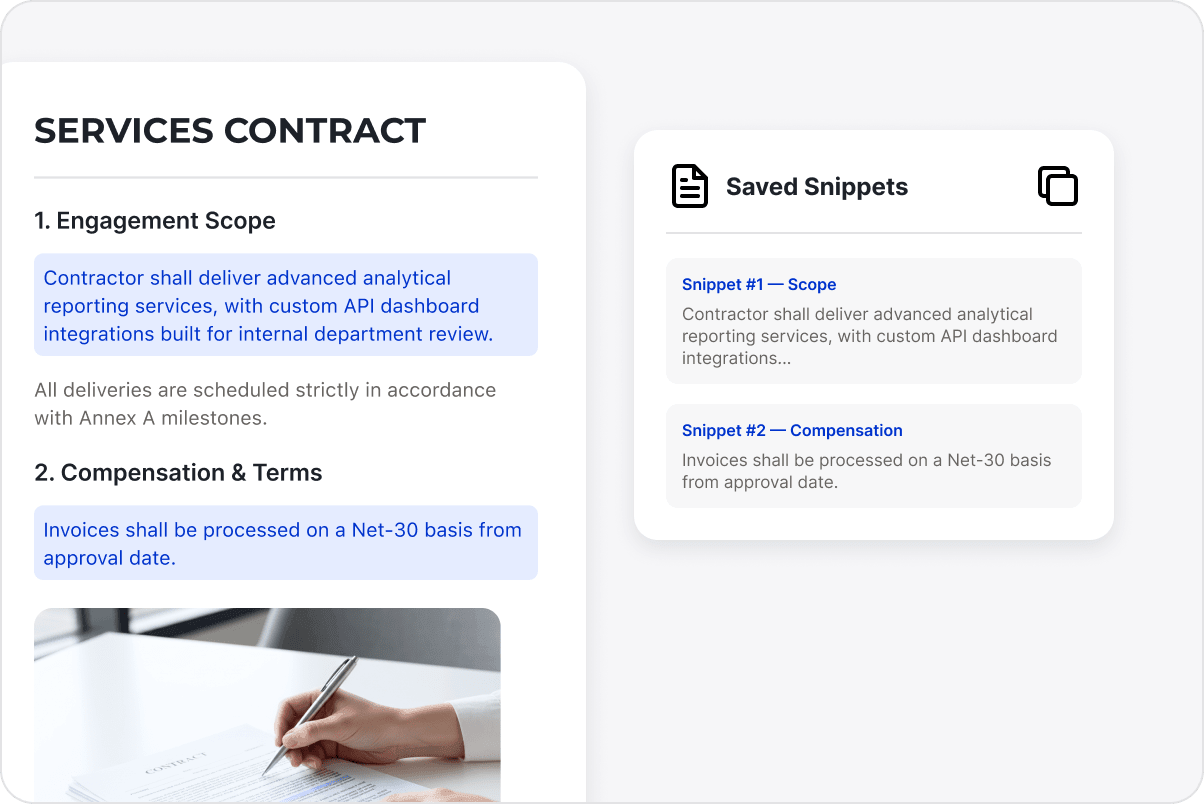
निकाले गए पाठ का उपयोग नोट्स बनाने, डेटा व्यवस्थित करने, सामग्री की समीक्षा करने या आंतरिक ज्ञान को संग्रहित करने के लिए करें, जिससे सामग्री को खोजने और कॉपी करने के लिए PDF फाइलों को दोबारा खोलने की आवश्यकता कम हो जाती है।
निकाले गए पाठ का उपयोग जारी रखें
नोट्स बनाने, सामग्री की समीक्षा करने, डेटा को व्यवस्थित करने और ज्ञान को एकत्रित करने के लिए निकाले गए पाठ का उपयोग जारी रखें, जिससे PDF में बार-बार खोज करने की आवश्यकता कम हो जाएगी।
LynxPDF विशेषज्ञ पुस्तकालय तक पहुँचें
उद्यम दस्तावेज़ प्रबंधन के लिए भविष्योन्मुखी अंतर्दृष्टि और रणनीतिक मार्गदर्शिकाएँ।
व्यावसायिक रूप से डिज़ाइन की गई और अधिक सुविधाओं का अन्वेषण करें