स्कैन की गई पीडीएफ फाइलों में मौजूद टेक्स्ट को पहचानें
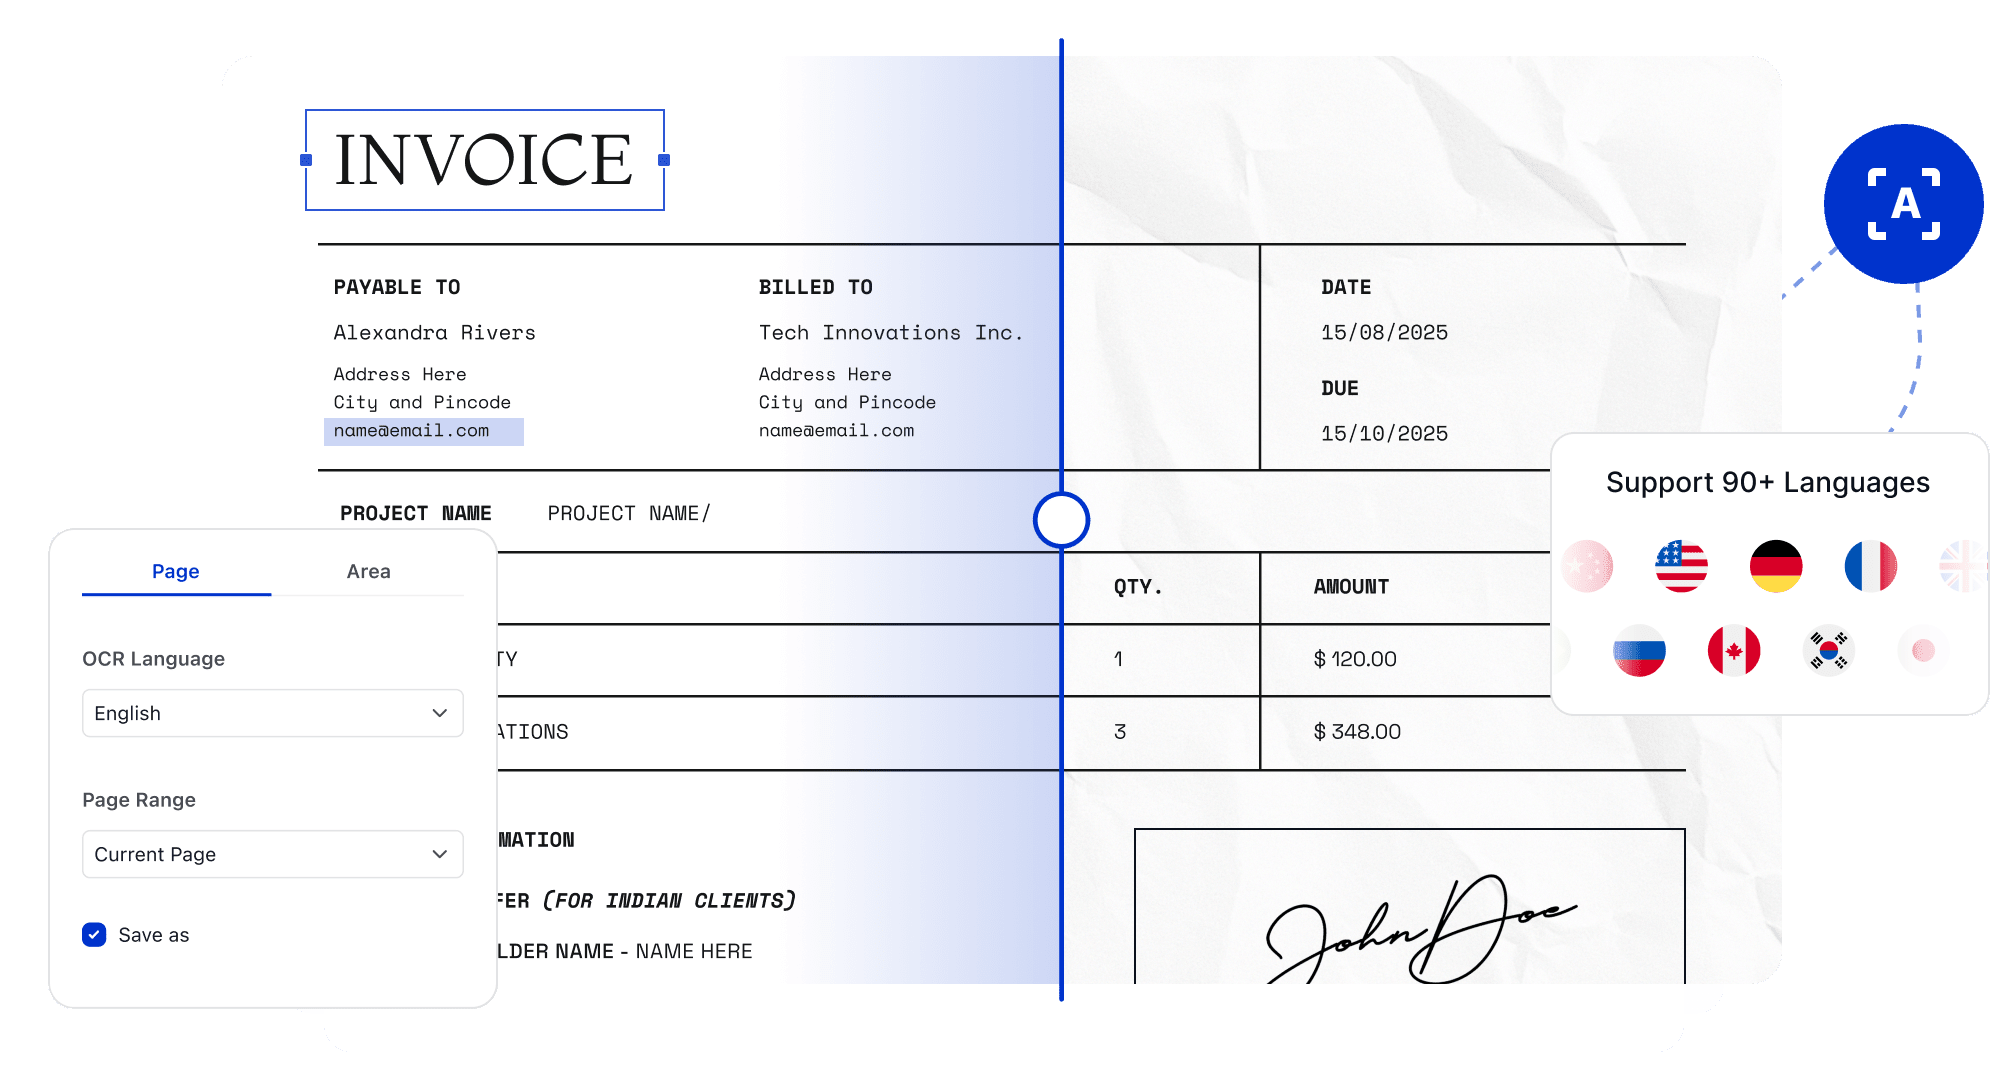
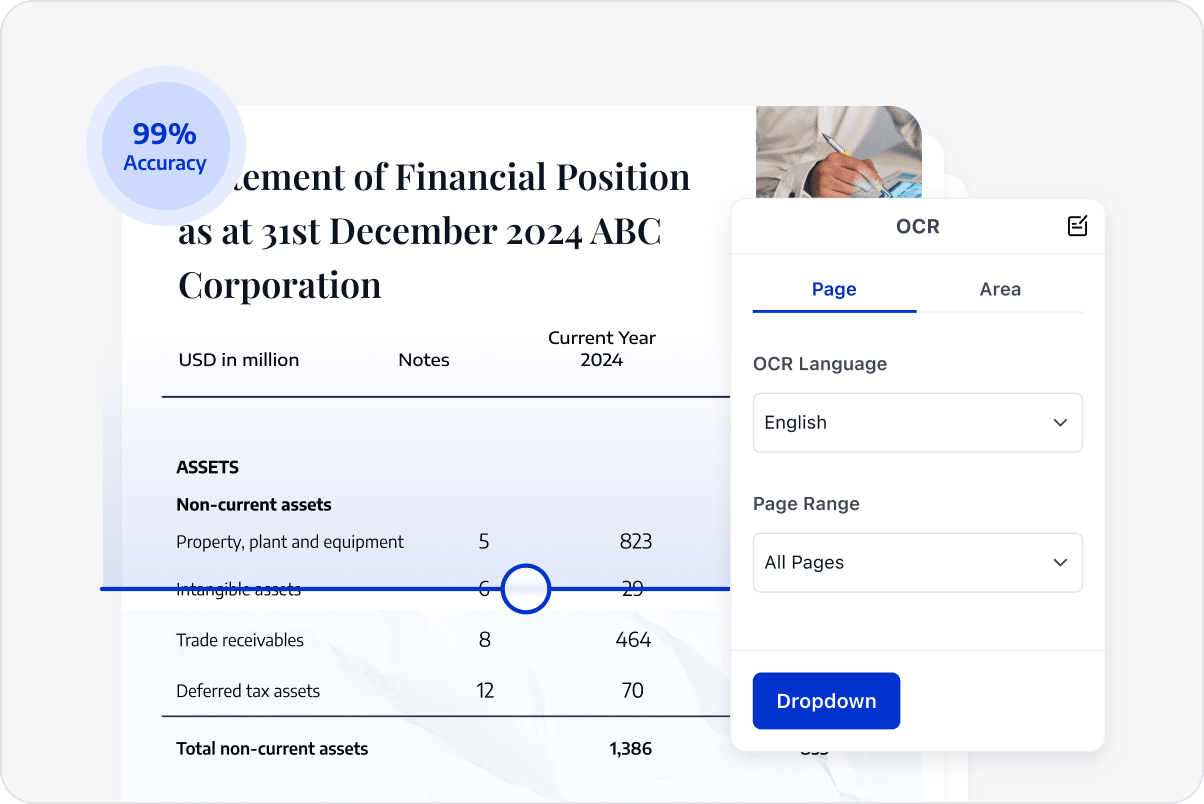
स्कैन की गई रिपोर्टों, अनुबंधों और ऐतिहासिक अभिलेखों पर OCR चलाकर छवि-आधारित पाठ को खोजने योग्य और कॉपी करने में आसान बनाएं।
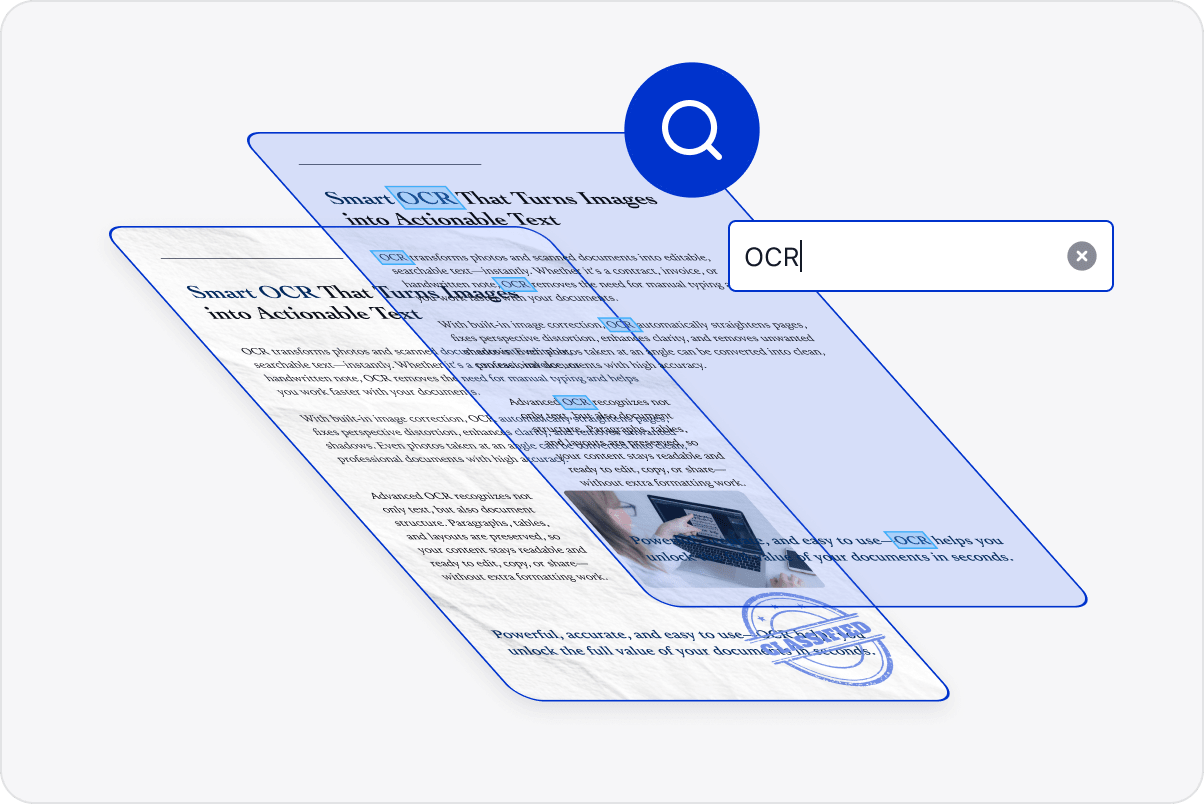
टेक्स्ट लेयर्स को बल्क में जोड़ें
एक ही बैच में टेक्स्ट लेयर्स जोड़ें ताकि टीमें पेज दर पेज खोजने के बजाय कीवर्ड द्वारा कंटेंट का पता लगा सकें।
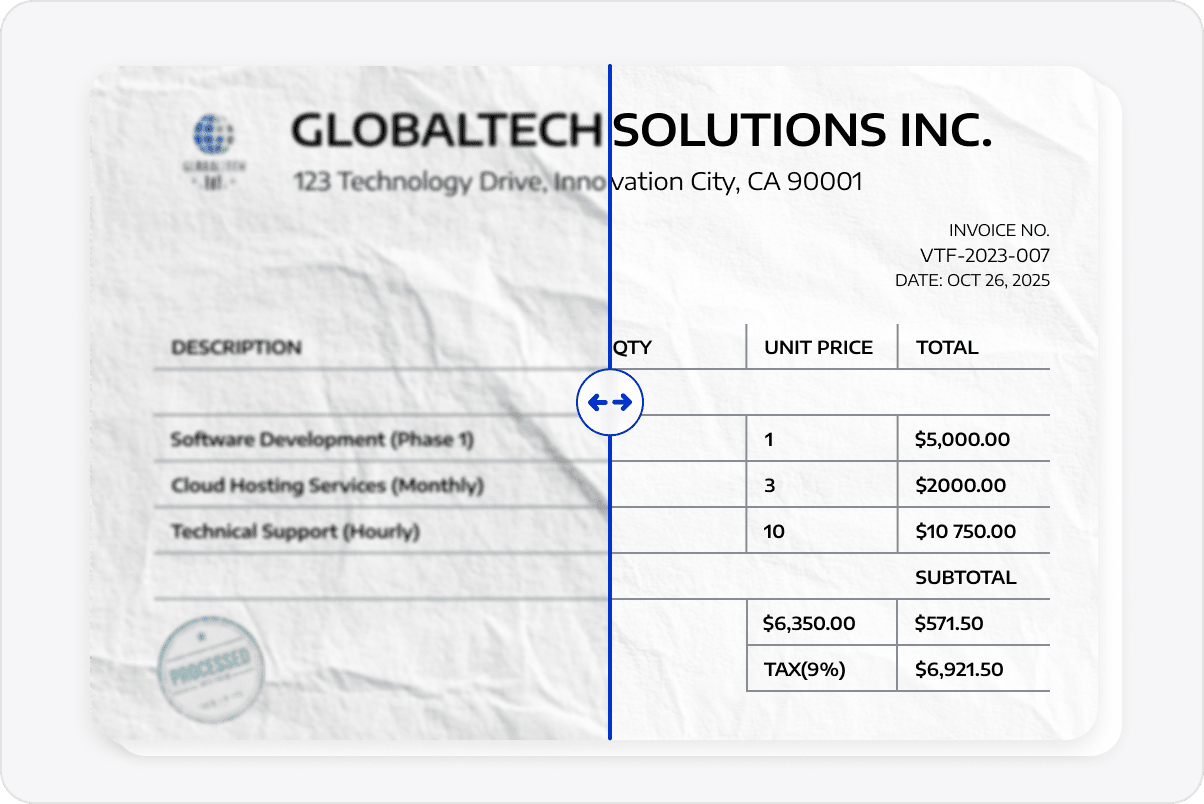
OCR के लिए छवि गुणवत्ता को सही करें
OCR के लिए इनपुट को बेहतर बनाने और पाठ, तालिकाओं और पृष्ठों को पढ़ने में आसान बनाने के लिए विकृत या टेढ़े-मेढ़े स्कैन को ठीक करें।
मूल पृष्ठ लेआउट को सुरक्षित रखें
संपादन, संग्रहण या डेटा निष्कर्षण के लिए पृष्ठ संरचना और दृश्य सामग्री को यथासंभव बनाए रखते हुए पाठ को पहचानें।
स्कैन किए गए दस्तावेज़ों के साथ काम करना जारी रखें
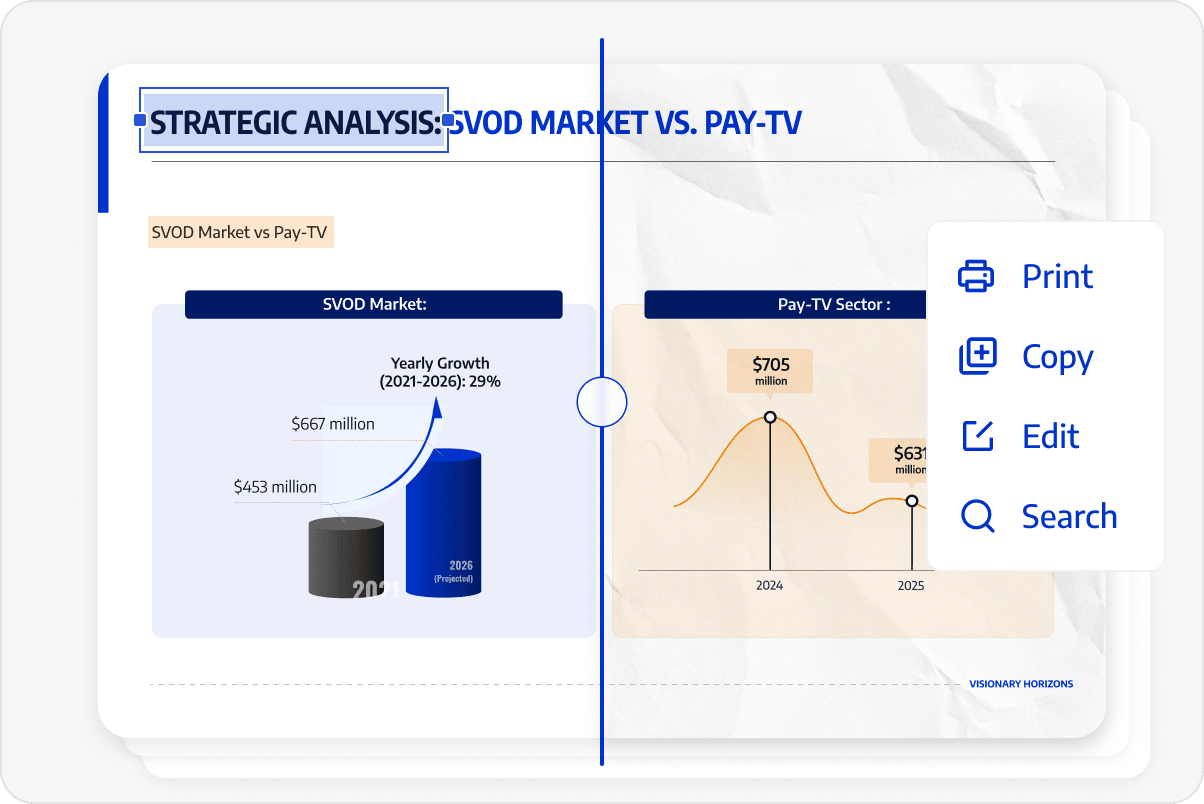
मान्यता प्राप्त दस्तावेजों का संपादन, प्रतिलिपि बनाना और उन्हें संग्रहित करना जारी रखें ताकि ऐतिहासिक सामग्री रोजमर्रा के काम और सामग्री वर्कफ़्लो में वापस आ सके।
LynxPDF विशेषज्ञ पुस्तकालय तक पहुँचें
उद्यम दस्तावेज़ प्रबंधन के लिए भविष्योन्मुखी अंतर्दृष्टि और रणनीतिक मार्गदर्शिकाएँ।
व्यावसायिक रूप से डिज़ाइन की गई और अधिक सुविधाओं का अन्वेषण करें