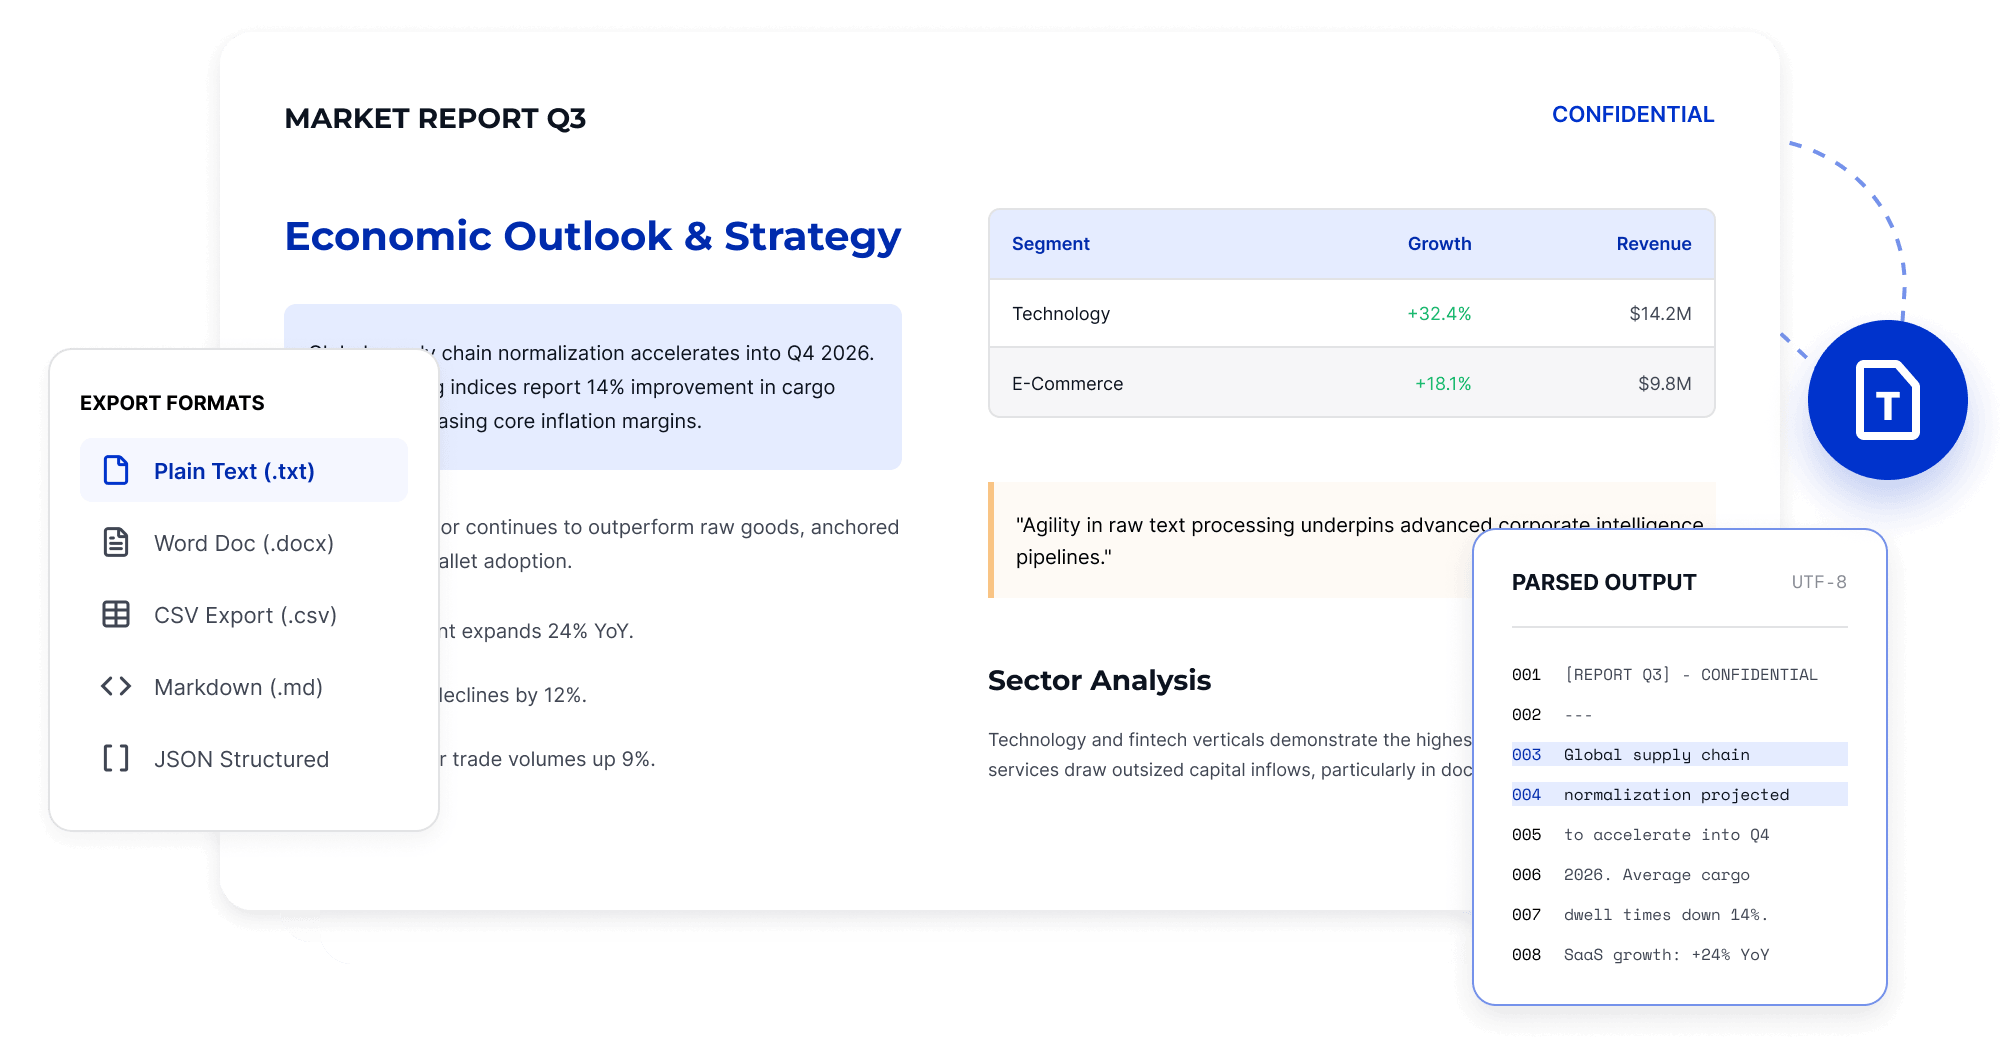
Extrahera sökbar text från rapporter, kontrakt och långa dokument för att minska manuell kopiering och organisation sida för sida, vilket gör det enklare att redigera, referera till och analysera.
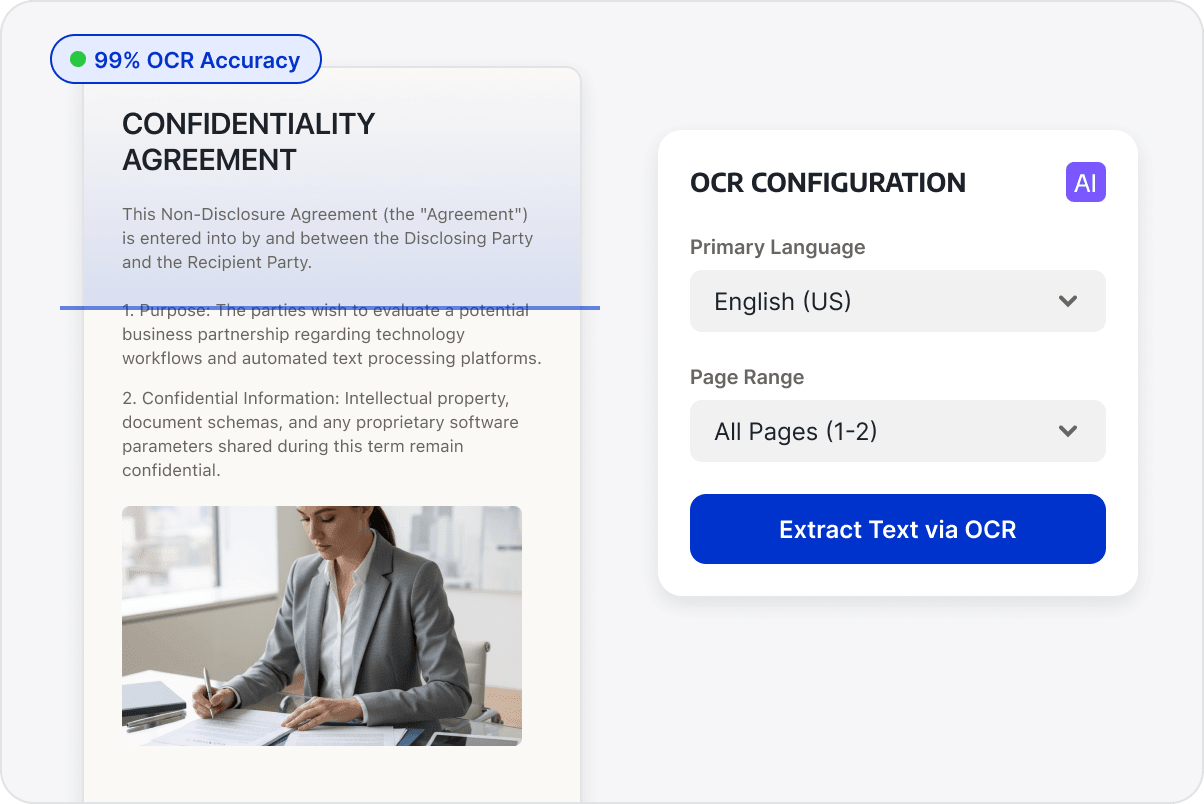
Tolka text i skannade PDF-filer
Använd OCR för att känna igen text på skannade sidor och bildbaserade PDF-filer före extrahering.
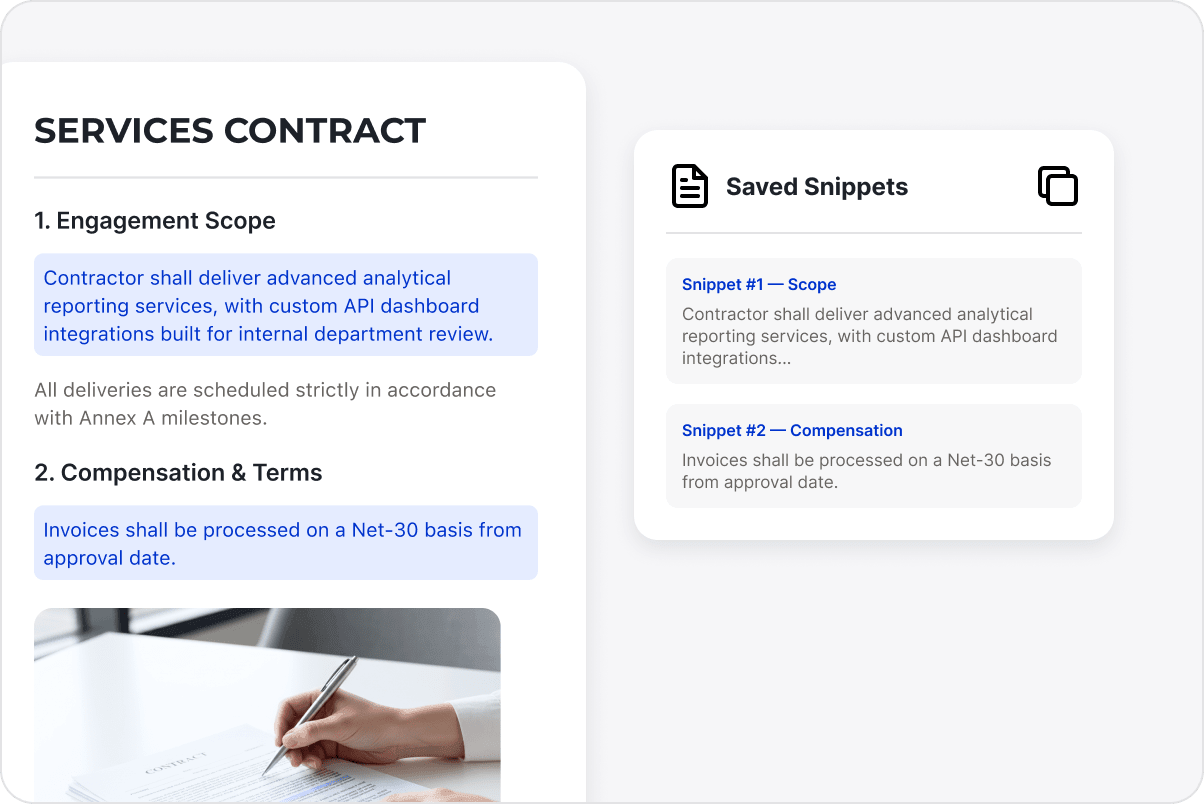
Återanvänd extraherad text
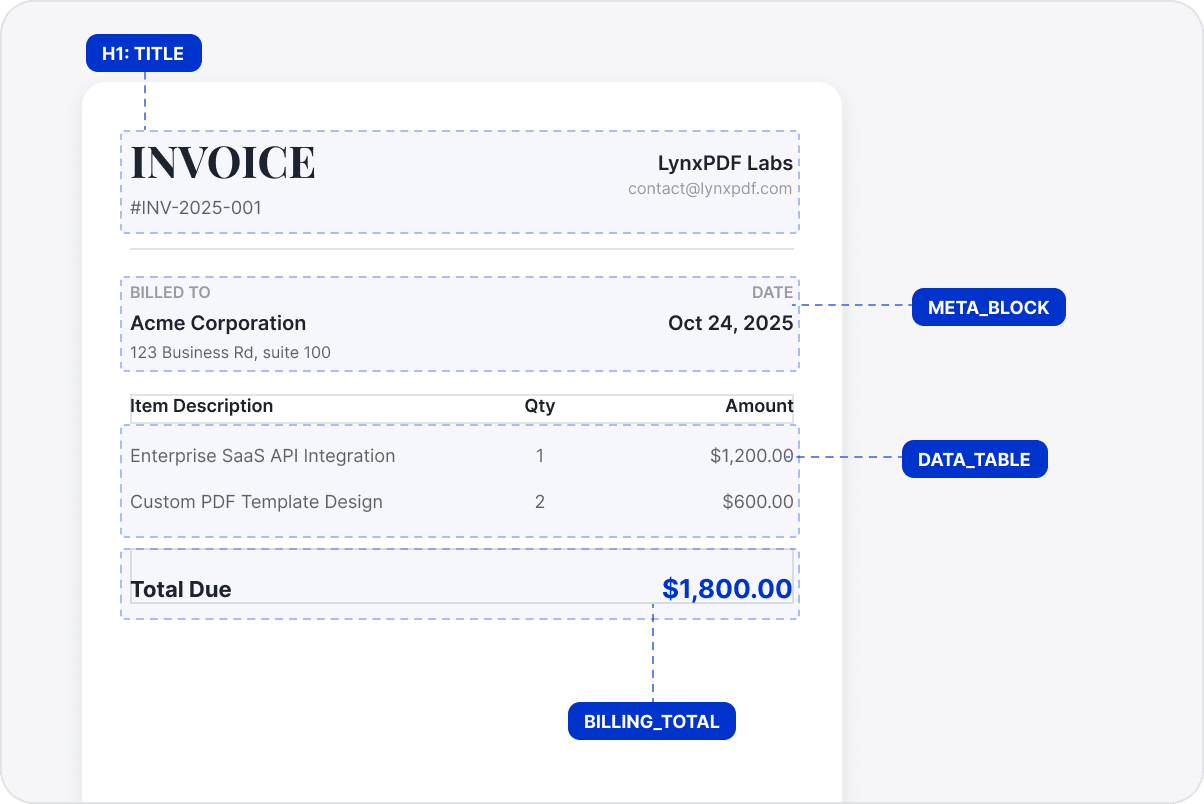
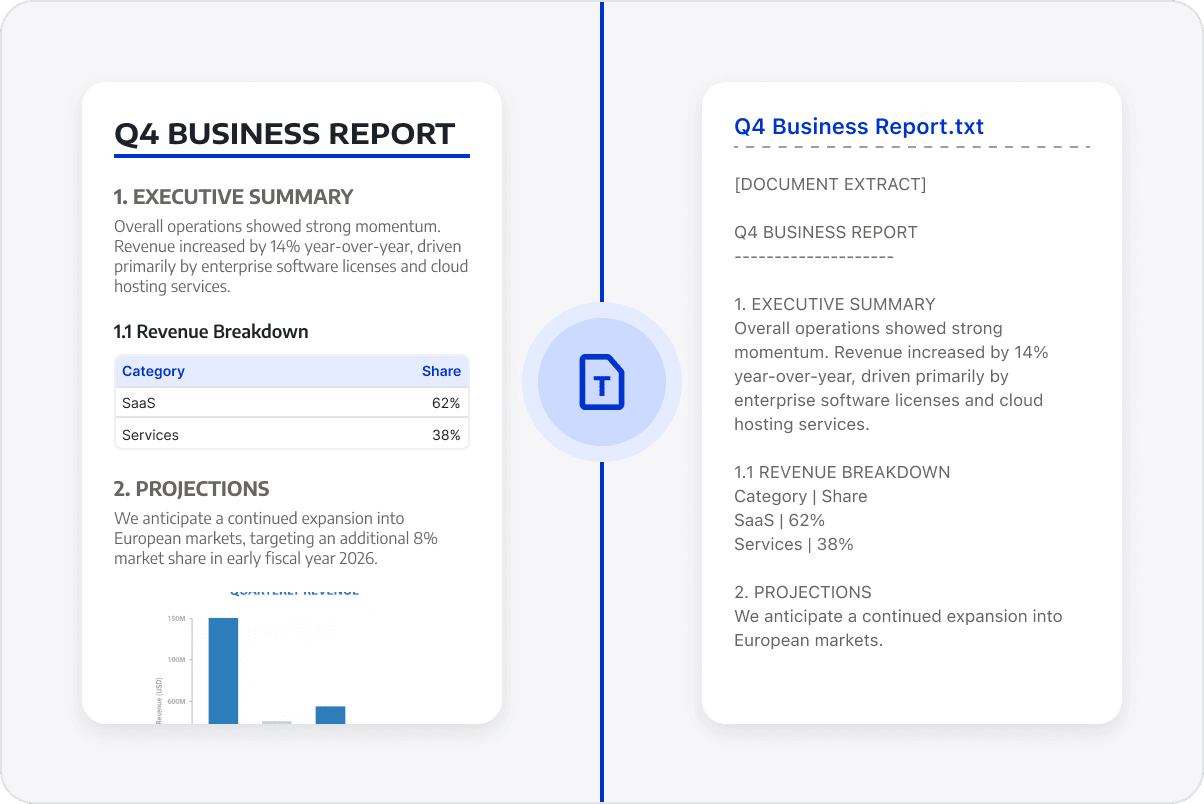
Organisera extraherad text i den ursprungliga läsordningen och bevara rubriker, stycken och viktiga innehållsrelationer där det är möjligt för att minska omformatering.
Fortsätt arbeta med extraherad text
Använd extraherad text för anteckningar, dataorganisation, innehållsgranskning eller intern kunskapsinsamling, vilket minskar behovet av att öppna PDF-filer igen för att hitta och kopiera innehåll.
Fortsätt använda extraherad text
Fortsätt använda extraherad text för anteckningar, innehållsgranskning, dataorganisation och kunskapsinsamling, vilket minskar upprepade sökningar i PDF-filen.
Tillgång till LynxPDF Expertbibliotek
Framåtblickande insikter och strategiska guider för företagets dokumenthantering.