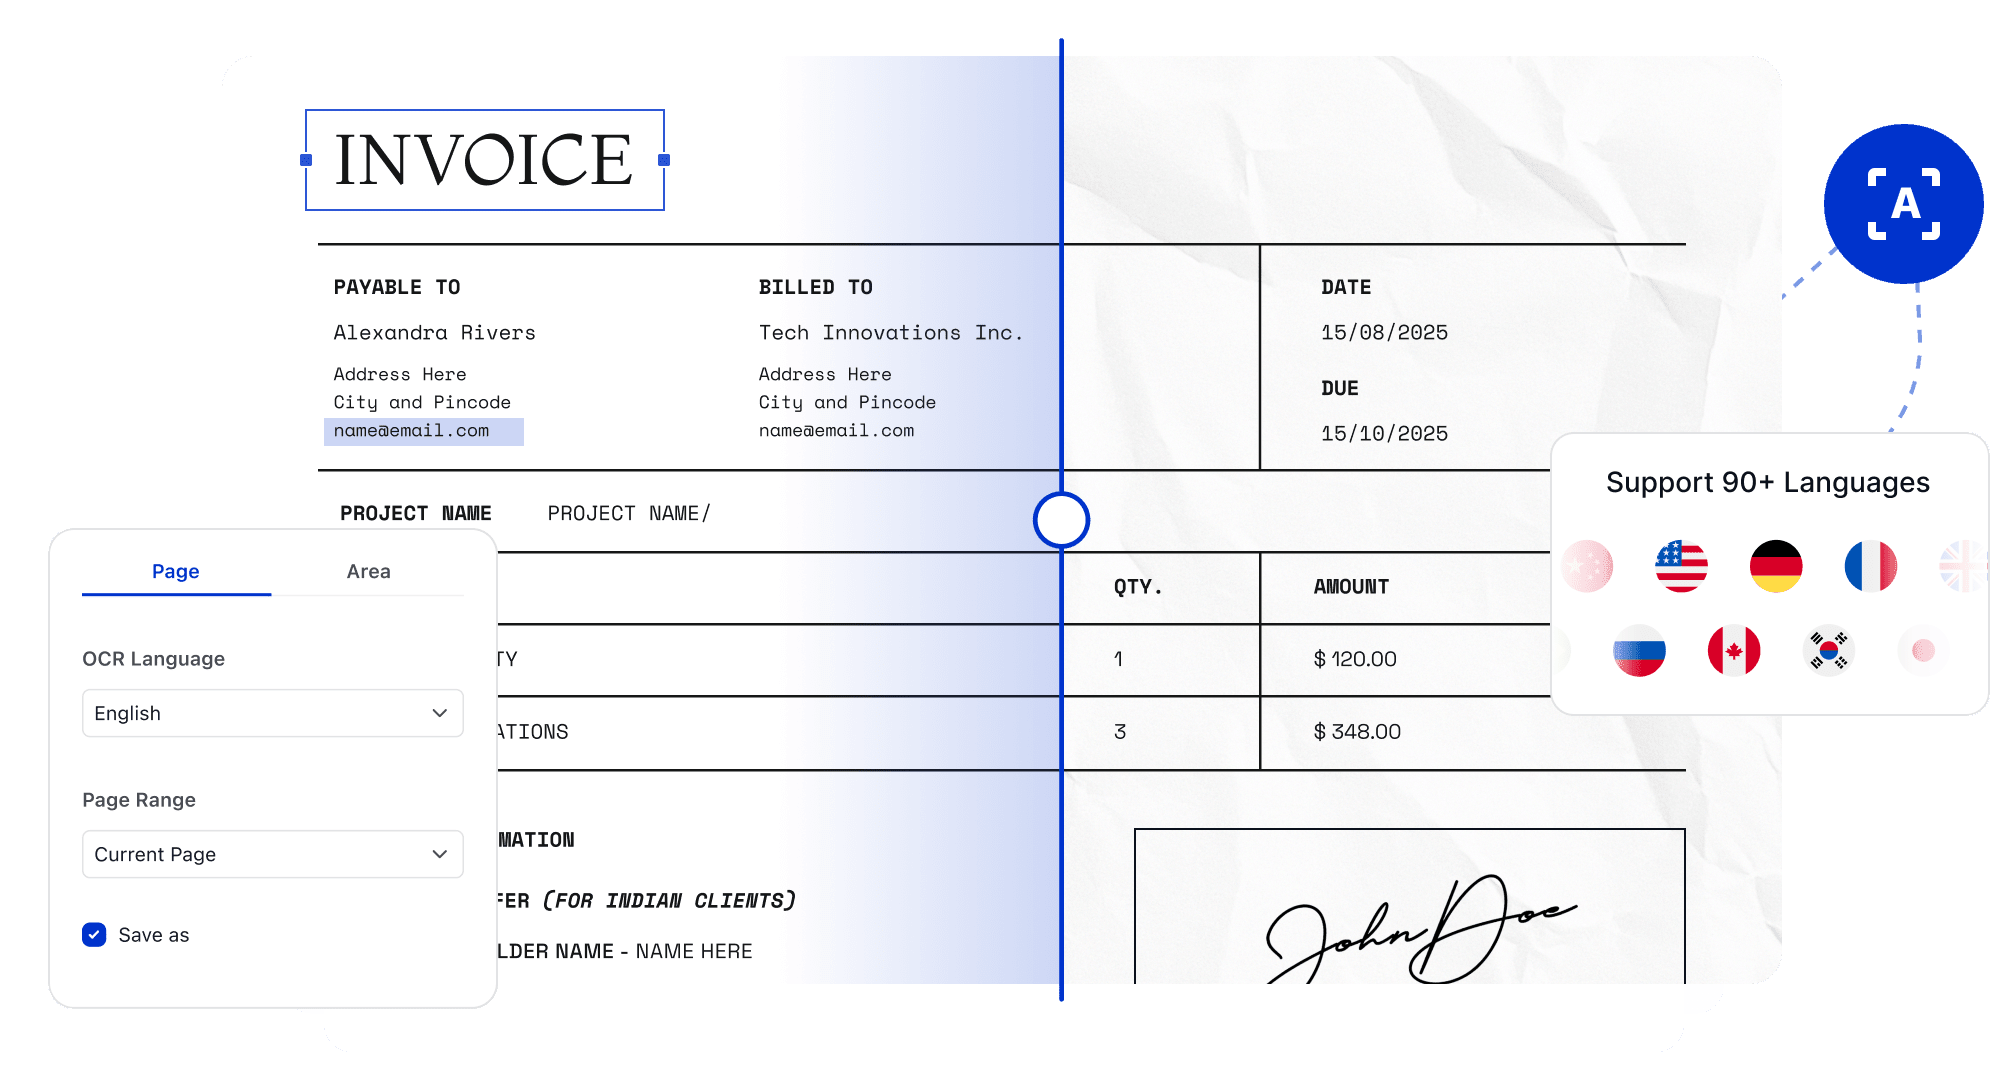
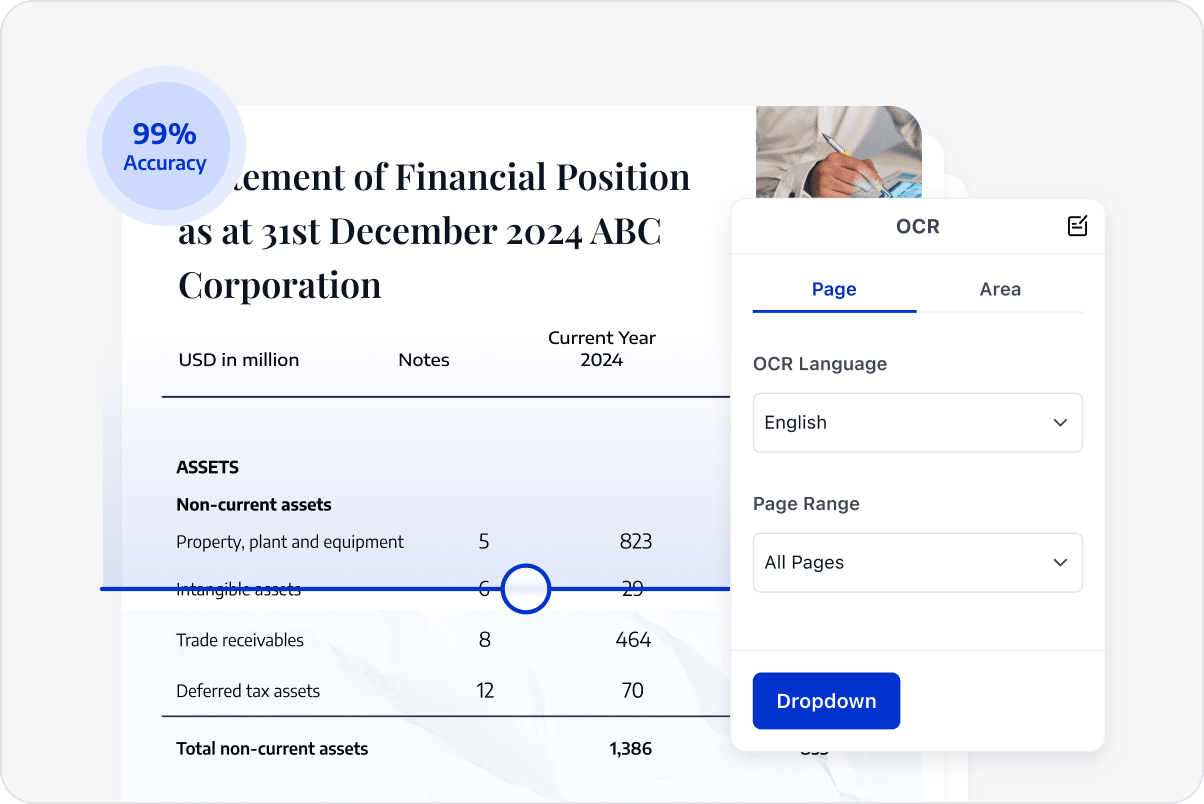
Примените технологию распознавания текста (OCR) к нескольким отсканированным PDF-файлам, чтобы сделать текст на основе изображений доступным для поиска, копирования и редактирования.
Распознавание текста на отсканированных PDF-файлах
Примените технологию распознавания текста (OCR) к отсканированным отчетам, контрактам и архивным документам, чтобы сделать текст на изображениях доступным для поиска и упростить его копирование.
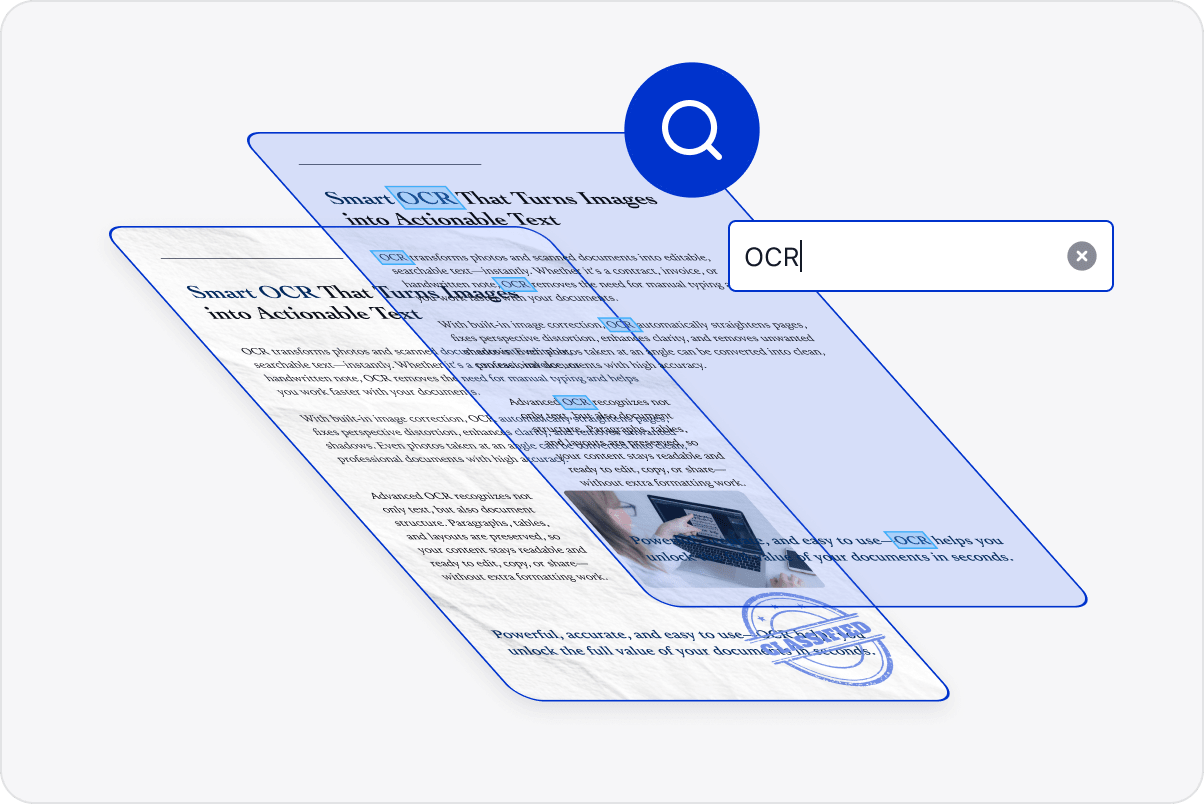
Добавление текстовых слоев одновременно.
Добавьте текстовые слои к пакету файлов, чтобы команды могли находить контент по ключевым словам, а не постранично.
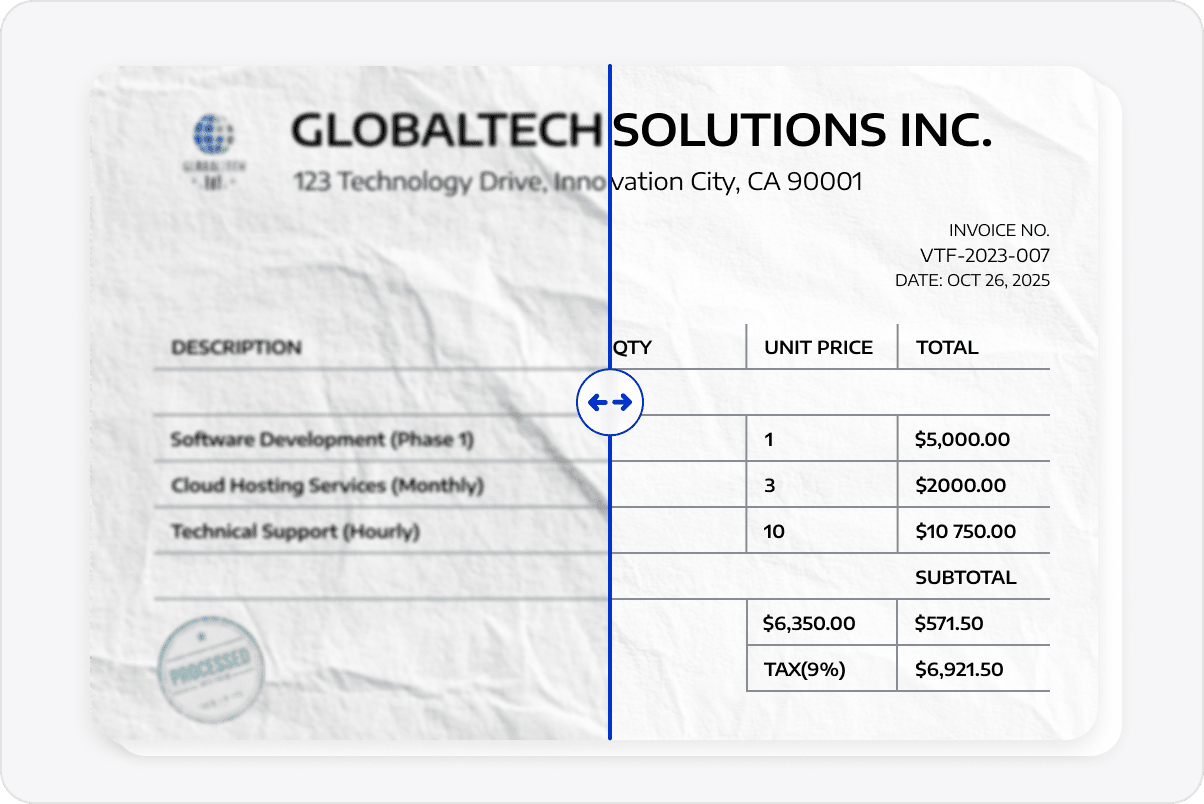
Правильное качество изображения для оптического распознавания символов
Исправьте искаженные или перекошенные сканы, чтобы улучшить входные данные для оптического распознавания текста и сделать текст, таблицы и страницы более читабельными.
Сохраните исходную структуру страницы.
Распознавайте текст, сохраняя при этом структуру страницы и визуальное содержание, где это возможно, для редактирования, архивирования или извлечения данных.
Продолжить работу со сканированными документами
Продолжайте редактировать, копировать и архивировать признанные документы, чтобы исторические материалы могли вернуться в повседневную работу и рабочие процессы, связанные с контентом.
Доступ к экспертной библиотеке LynxPDF
Перспективные аналитические материалы и стратегические руководства по управлению корпоративными документами.
Ознакомьтесь с дополнительными функциями для бизнеса