阿富汗
奥兰群岛
阿尔巴尼亚
阿尔及利亚
美属萨摩亚
安道尔
安哥拉
安圭拉
安提瓜和巴布达
阿根廷
亚美尼亚
阿鲁巴
澳大利亚
奥地利
阿塞拜疆
巴哈马
巴林
孟加拉国
巴巴多斯
白俄罗斯
比利时
伯利兹
贝宁
百慕大
不丹
玻利维亚
博奈尔、圣尤斯特歇斯和萨巴
波斯尼亚和黑塞哥维那
博茨瓦纳
布韦岛
巴西
英属印度洋领地
英属维尔京群岛
文莱
保加利亚
布基纳法索
布隆迪
柬埔寨
喀麦隆
加拿大
佛得角
开曼群岛
中非共和国
乍得
智利
中国
圣诞岛
科科斯(基林)群岛
哥伦比亚
科摩罗
刚果
库克群岛
哥斯达黎加
科特迪瓦
克罗地亚
库拉索
塞浦路斯
捷克共和国
丹麦
吉布提
多米尼克
多米尼加共和国
厄瓜多尔
埃及
萨尔瓦多
赤道几内亚
厄立特里亚
爱沙尼亚
埃塞俄比亚
福克兰群岛
法罗群岛
斐济
芬兰
法国
法属圭亚那
法属波利尼西亚
法属南部领地
加蓬
冈比亚
格鲁吉亚
德国
加纳
直布罗陀
希腊
格陵兰
格林纳达
瓜德罗普
关岛
危地马拉
根西岛
几内亚
几内亚比绍
圭亚那
海地
赫德岛和麦克唐纳群岛
梵蒂冈
洪都拉斯
香港
匈牙利
冰岛
印度
印度尼西亚
伊拉克
爱尔兰
马恩岛
以色列
意大利
牙买加
日本
泽西岛
约旦
哈萨克斯坦
肯尼亚
基里巴斯
科威特
吉尔吉斯斯坦
老挝
拉脱维亚
黎巴嫩
莱索托
利比里亚
利比亚
列支敦士登
立陶宛
卢森堡
澳门
北马其顿
马达加斯加
马拉维
马来西亚
马尔代夫
马里
马耳他
马绍尔群岛
马提尼克
毛里塔尼亚
毛里求斯
马约特
墨西哥
密克罗尼西亚
摩尔多瓦
摩纳哥
蒙古
黑山
蒙特塞拉特
摩洛哥
莫桑比克
缅甸
纳米比亚
瑙鲁
尼泊尔
荷兰
荷属安的列斯
新喀里多尼亚
新西兰
尼加拉瓜
尼日尔
尼日利亚
纽埃
诺福克岛
北马里亚纳群岛
挪威
阿曼
巴基斯坦
帕劳
巴勒斯坦
巴拿马
巴布亚新几内亚
巴拉圭
秘鲁
菲律宾
皮特凯恩群岛
波兰
葡萄牙
波多黎各
卡塔尔
塞尔维亚
留尼汪
罗马尼亚
俄罗斯
卢旺达
南乔治亚和南桑威奇群岛
圣赫勒拿
圣基茨和尼维斯
圣卢西亚
圣马丁
圣皮埃尔和密克隆
圣文森特和格林纳丁斯
萨摩亚
圣马力诺
圣多美和普林西比
沙特阿拉伯
塞内加尔
塞舌尔
塞拉利昂
新加坡
斯洛伐克
斯洛文尼亚
所罗门群岛
索马里
南非
韩国
西班牙
斯里兰卡
苏丹
苏里南
斯瓦尔巴和扬马延
斯威士兰
瑞典
瑞士
台湾
塔吉克斯坦
坦桑尼亚
泰国
东帝汶
多哥
托克劳
汤加
特立尼达和多巴哥
突尼斯
土耳其
土库曼斯坦
特克斯和凯科斯群岛
图瓦卢
美属维尔京群岛
乌干达
乌克兰
阿联酋
英国
美国
美国本土外小岛屿
乌拉圭
乌兹别克斯坦
瓦努阿图
委内瑞拉
越南
瓦利斯和富图纳
西撒哈拉
也门
赞比亚
津巴布韦
未找到匹配项
+93-阿富汗
+355-阿尔巴尼亚
+213-阿尔及利亚
+1-美属萨摩亚
+376-安道尔
+244-安哥拉
+1-安圭拉
+672-南极洲
+1-安提瓜和巴布达
+54-阿根廷
+374-亚美尼亚
+297-阿鲁巴
+61-澳大利亚
+43-奥地利
+994-阿塞拜疆
+1-巴哈马
+973-巴林
+880-孟加拉国
+1-巴巴多斯
+375-白俄罗斯
+32-比利时
+501-伯利兹
+229-贝宁
+1-百慕大
+975-不丹
+591-玻利维亚
+387-波斯尼亚和黑塞哥维那
+267-博茨瓦纳
+55-巴西
+246-英属印度洋领地
+673-文莱
+359-保加利亚
+226-布基纳法索
+257-布隆迪
+855-柬埔寨
+237-喀麦隆
+1-加拿大
+238-佛得角
+1-开曼群岛
+236-中非共和国
+235-乍得
+56-智利
+86-中国
+61-圣诞岛
+61-科科斯(基林)群岛
+57-哥伦比亚
+269-科摩罗
+243-刚果(金)
+242-刚果(布)
+682-库克群岛
+506-哥斯达黎加
+225-科特迪瓦
+385-克罗地亚
+53-古巴
+357-塞浦路斯
+420-捷克
+45-丹麦
+253-吉布提
+1-多米尼克
+1-多米尼加共和国
+593-厄瓜多尔
+20-埃及
+503-萨尔瓦多
+240-赤道几内亚
+291-厄立特里亚
+372-爱沙尼亚
+268-斯威士兰
+251-埃塞俄比亚
+500-福克兰群岛
+298-法罗群岛
+679-斐济
+358-芬兰
+33-法国
+594-法属圭亚那
+689-法属波利尼西亚
+241-加蓬
+220-冈比亚
+995-格鲁吉亚
+49-德国
+233-加纳
+350-直布罗陀
+30-希腊
+299-格陵兰
+1-格林纳达
+590-瓜德罗普
+1-关岛
+502-危地马拉
+224-几内亚
+245-几内亚比绍
+592-圭亚那
+509-海地
+504-洪都拉斯
+852-香港
+36-匈牙利
+354-冰岛
+91-印度
+62-印度尼西亚
+98-伊朗
+964-伊拉克
+353-爱尔兰
+972-以色列
+39-意大利
+1-牙买加
+81-日本
+962-约旦
+7-哈萨克斯坦
+254-肯尼亚
+686-基里巴斯
+850-朝鲜
+82-韩国
+965-科威特
+996-吉尔吉斯斯坦
+856-老挝
+371-拉脱维亚
+961-黎巴嫩
+266-莱索托
+231-利比里亚
+218-利比亚
+423-列支敦士登
+370-立陶宛
+352-卢森堡
+853-澳门
+261-马达加斯加
+265-马拉维
+60-马来西亚
+960-马尔代夫
+223-马里
+356-马耳他
+692-马绍尔群岛
+596-马提尼克
+222-毛里塔尼亚
+230-毛里求斯
+262-马约特
+52-墨西哥
+691-密克罗尼西亚
+373-摩尔多瓦
+377-摩纳哥
+976-蒙古
+382-黑山
+1-蒙特塞拉特
+212-摩洛哥
+258-莫桑比克
+95-缅甸
+264-纳米比亚
+674-瑙鲁
+977-尼泊尔
+31-荷兰
+687-新喀里多尼亚
+64-新西兰
+505-尼加拉瓜
+227-尼日尔
+234-尼日利亚
+683-纽埃
+672-诺福克岛
+389-北马其顿
+1-北马里亚纳群岛
+47-挪威
+968-阿曼
+92-巴基斯坦
+680-帕劳
+970-巴勒斯坦
+507-巴拿马
+675-巴布亚新几内亚
+595-巴拉圭
+51-秘鲁
+63-菲律宾
+48-波兰
+351-葡萄牙
+1-波多黎各
+974-卡塔尔
+262-留尼汪
+40-罗马尼亚
+7-俄罗斯
+250-卢旺达
+590-圣巴泰勒米
+290-圣赫勒拿
+1-圣基茨和尼维斯
+1-圣卢西亚
+590-圣马丁
+508-圣皮埃尔和密克隆
+1-圣文森特和格林纳丁斯
+685-萨摩亚
+378-圣马力诺
+239-圣多美和普林西比
+966-沙特阿拉伯
+221-塞内加尔
+381-塞尔维亚
+248-塞舌尔
+232-塞拉利昂
+65-新加坡
+1-荷属圣马丁
+421-斯洛伐克
+386-斯洛文尼亚
+677-所罗门群岛
+252-索马里
+27-南非
+211-南苏丹
+34-西班牙
+94-斯里兰卡
+249-苏丹
+597-苏里南
+46-瑞典
+41-瑞士
+963-叙利亚
+886-台湾(地区)
+992-塔吉克斯坦
+255-坦桑尼亚
+66-泰国
+670-东帝汶
+228-多哥
+690-托克劳
+676-汤加
+1-特立尼达和多巴哥
+216-突尼斯
+90-土耳其
+993-土库曼斯坦
+1-特克斯和凯科斯群岛
+688-图瓦卢
+256-乌干达
+380-乌克兰
+971-阿拉伯联合酋长国
+44-英国
+1-美国
+598-乌拉圭
+998-乌兹别克斯坦
+678-瓦努阿图
+58-委内瑞拉
+84-越南
+1-英属维尔京群岛
+1-美属维尔京群岛
+681-瓦利斯和富图纳
+967-也门
+260-赞比亚
+263-津巴布韦
No data
产品
LynxPDF
企业版
LynxPDF for Windows
LynxPDF for Mac
LynxPDF for iOS
新增
LynxPDF for Android
新增
LynxPDF Web
管理控制台
在线工具
PDF 转 Word
PDF 转 Excel
PDF 转 PPT
PDF 转图片
合并 PDF
压缩 PDF
编辑 PDF
OCR PDF
批量 PDF 转 Word
批量压缩
所有工具
功能
编辑 PDF
转换 PDF
注释 PDF
签名 PDF
填写表单
PDF 对比
密文标记
新增
保护 PDF
阅读 PDF
PDF OCR
整理 PDF
拆分 PDF
新增
PDF 文字转语音
新增
所有功能
行业解决方案
行业解决方案
教育
建筑
制造业
IT服务
医疗保健
金融
物流
法律服务
人力资源
采购
咨询服务
零售电商
房地产
会计团队
销售团队
政府与公共部门
法务团队
保险与理赔
美国非营利组织
资源
资源
常见问题
文章
白皮书
新增
客户案例
关于我们
联系我们
GDPR
竞品对比
定价
代理商
联系销售
免费下载
登录
English (U.S.)
English (Australia)
English (Canada)
English (U.K.)
Français
Français (Canada)
Español (México)
Español
العربية
Русский язык
中文 (简体)
中文 (繁體)
Português (Brasil)
Português (Portugal)
Deutsch
हिन्दी
Bahasa Indonesia
Bahasa Melayu
日本語 (にほんご)
Italiano
Nederlands
Türkçe
Polski
Українська
Svenska
Ελληνικά
ภาษาไทย (Phasa Thai)
Tiếng Việt
한국어
Română
Čeština
Magyar
Suomi
עברית
Norsk
Dansk
Slovenčina
Hrvatski
Català
English (U.S.)
English (Australia)
English (Canada)
English (U.K.)
Français
Français (Canada)
Español (México)
Español
العربية
Русский язык
中文 (简体)
中文 (繁體)
Português (Brasil)
Português (Portugal)
Deutsch
हिन्दी
Bahasa Indonesia
Bahasa Melayu
日本語 (にほんご)
Italiano
Nederlands
Türkçe
Polski
Українська
Svenska
Ελληνικά
ภาษาไทย (Phasa Thai)
Tiếng Việt
한국어
Română
Čeština
Magyar
Suomi
עברית
Norsk
Dansk
Slovenčina
Hrvatski
Català
产品
LynxPDF
企业版
LynxPDF for Windows
LynxPDF for Mac
LynxPDF for iOS
新增
LynxPDF for Android
新增
LynxPDF Web
管理控制台
在线工具
PDF 转 Word
PDF 转 Excel
PDF 转 PPT
PDF 转图片
合并 PDF
压缩 PDF
编辑 PDF
OCR PDF
批量 PDF 转 Word
批量压缩
所有工具
功能
编辑 PDF
转换 PDF
注释 PDF
签名 PDF
填写表单
PDF 对比
密文标记
新增
保护 PDF
阅读 PDF
PDF OCR
整理 PDF
拆分 PDF
新增
PDF 文字转语音
新增
所有功能
行业解决方案
教育
建筑
制造业
IT服务
医疗保健
金融
物流
法律服务
人力资源
采购
咨询服务
零售电商
房地产
会计团队
销售团队
政府与公共部门
法务团队
保险与理赔
美国非营利组织
资源
常见问题
文章
白皮书
新增
客户案例
关于我们
联系我们
GDPR
竞品对比
定价
代理商
联系销售
登录
免费下载
固定版式 PDF,也能转成
网页可用内容
将 PDF 转换为 HTML,减少重新录入和排版的工作,方便继续整理文档内容。
联系销售团队
免费试用
解析 PDF 内容
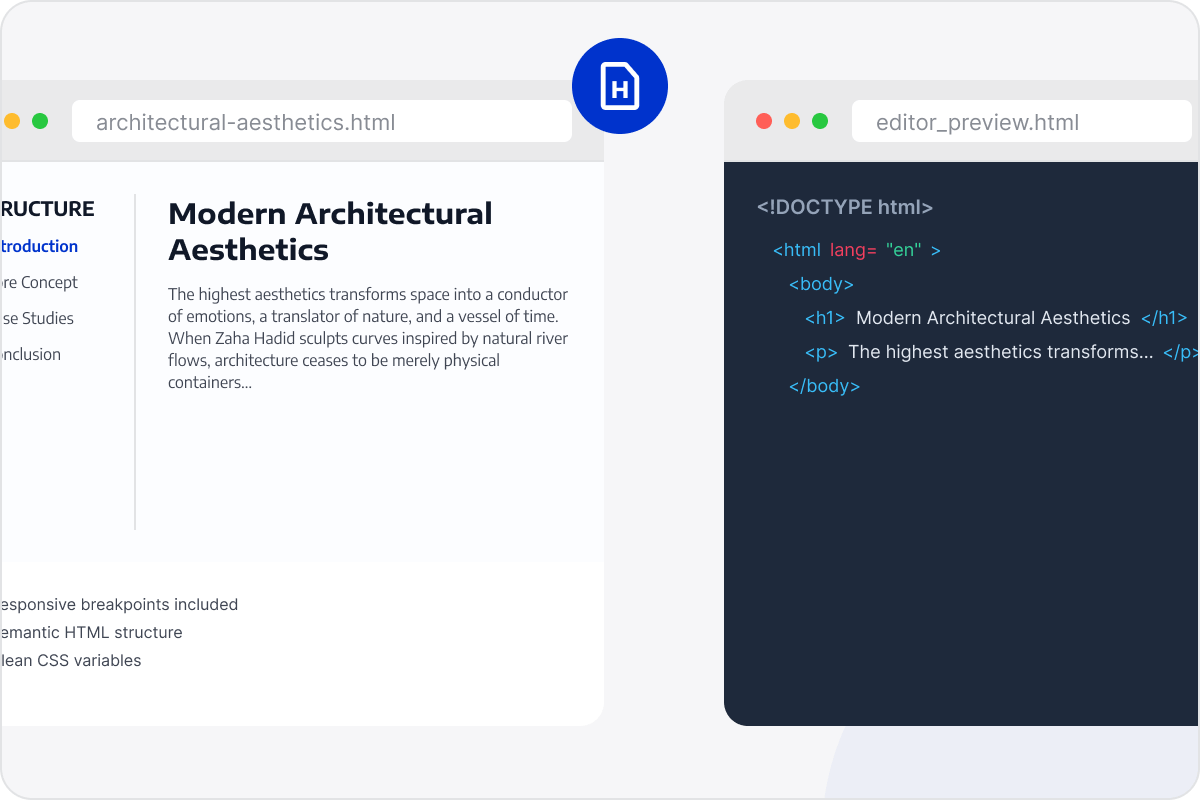
识别 PDF 中的文字、图片、字体、颜色和基础版式信息,为后续生成 HTML 提供内容与视觉依据。
生成 HTML 文件
将解析后的内容生成 HTML,尽量延续原文档的字体、颜色、间距和页面关系,减少从零编写 CSS 的工作。
降低还原误差
减少人工对照 PDF 逐项复制和调整样式的工作,降低文字、图片与页面关系在重新制作时出现差异的可能。
保持转换一致
按相同方式处理多份 PDF 时,尽量保持页面结构和基础样式一致,减少不同文件之间的排版差异。
便于后续维护
HTML 内容可以继续修改文字、图片和基础样式,文档更新时无需每次都从 PDF 重新开始整理。
访问 LynxPDF 专家资源库
获取企业文档管理的前瞻洞察与战略指南。
浏览全部白皮书
浏览全部白皮书
探索LynxPDF更多企业定制化功能
编辑
表单与签名
安全
注释
OCR
阅读
探索教程与热门内容
新手入门指南
Which File Formats Can I Convert Using LynxPDF?
How to activate LynxPDF through License Code?
LynxPDF vs Kofax Power PDF
Why LynxPDF is the Best Adobe Acrobat Alternative for Enterprise Use?
How about LynxPDF’s OCR, and What are Its Main Advantages?
Does LynxPDF Support Batch Processing?
Does LynxPDF Support Digital Signatures?
Does LynxPDF Support Web, Mobile, and Team Collaboration?
更多常见问题
热门精选文章
ABBYY FineReader PDF Alternative: Enterprise PDF Management Comparison
Thu. 27 Aug. 2026
Sejda vs LynxPDF: Linux Flexibility or Managed PDF Operations?
Wed. 26 Aug. 2026
Smallpdf vs LynxPDF: When PDF Work Needs More Control
Wed. 26 Aug. 2026
更多文章
联系销售团队
我们很高兴为您解答关于 LynxPDF 的所有问题。只需填写此表单,销售代表将尽快联系您,为您提供以下支持:
免费试用14天 LynxPDF 产品与管理控制台。
为您的组织选择最合适的定价方案。
探索适合您团队的应用场景和案例。
解锁高达 50% 的批量折扣
公司邮箱
姓名
公司名称
国家/地区
搜索并选择
电话号码
搜索并选择
-
描述您的需求
0 / 1000