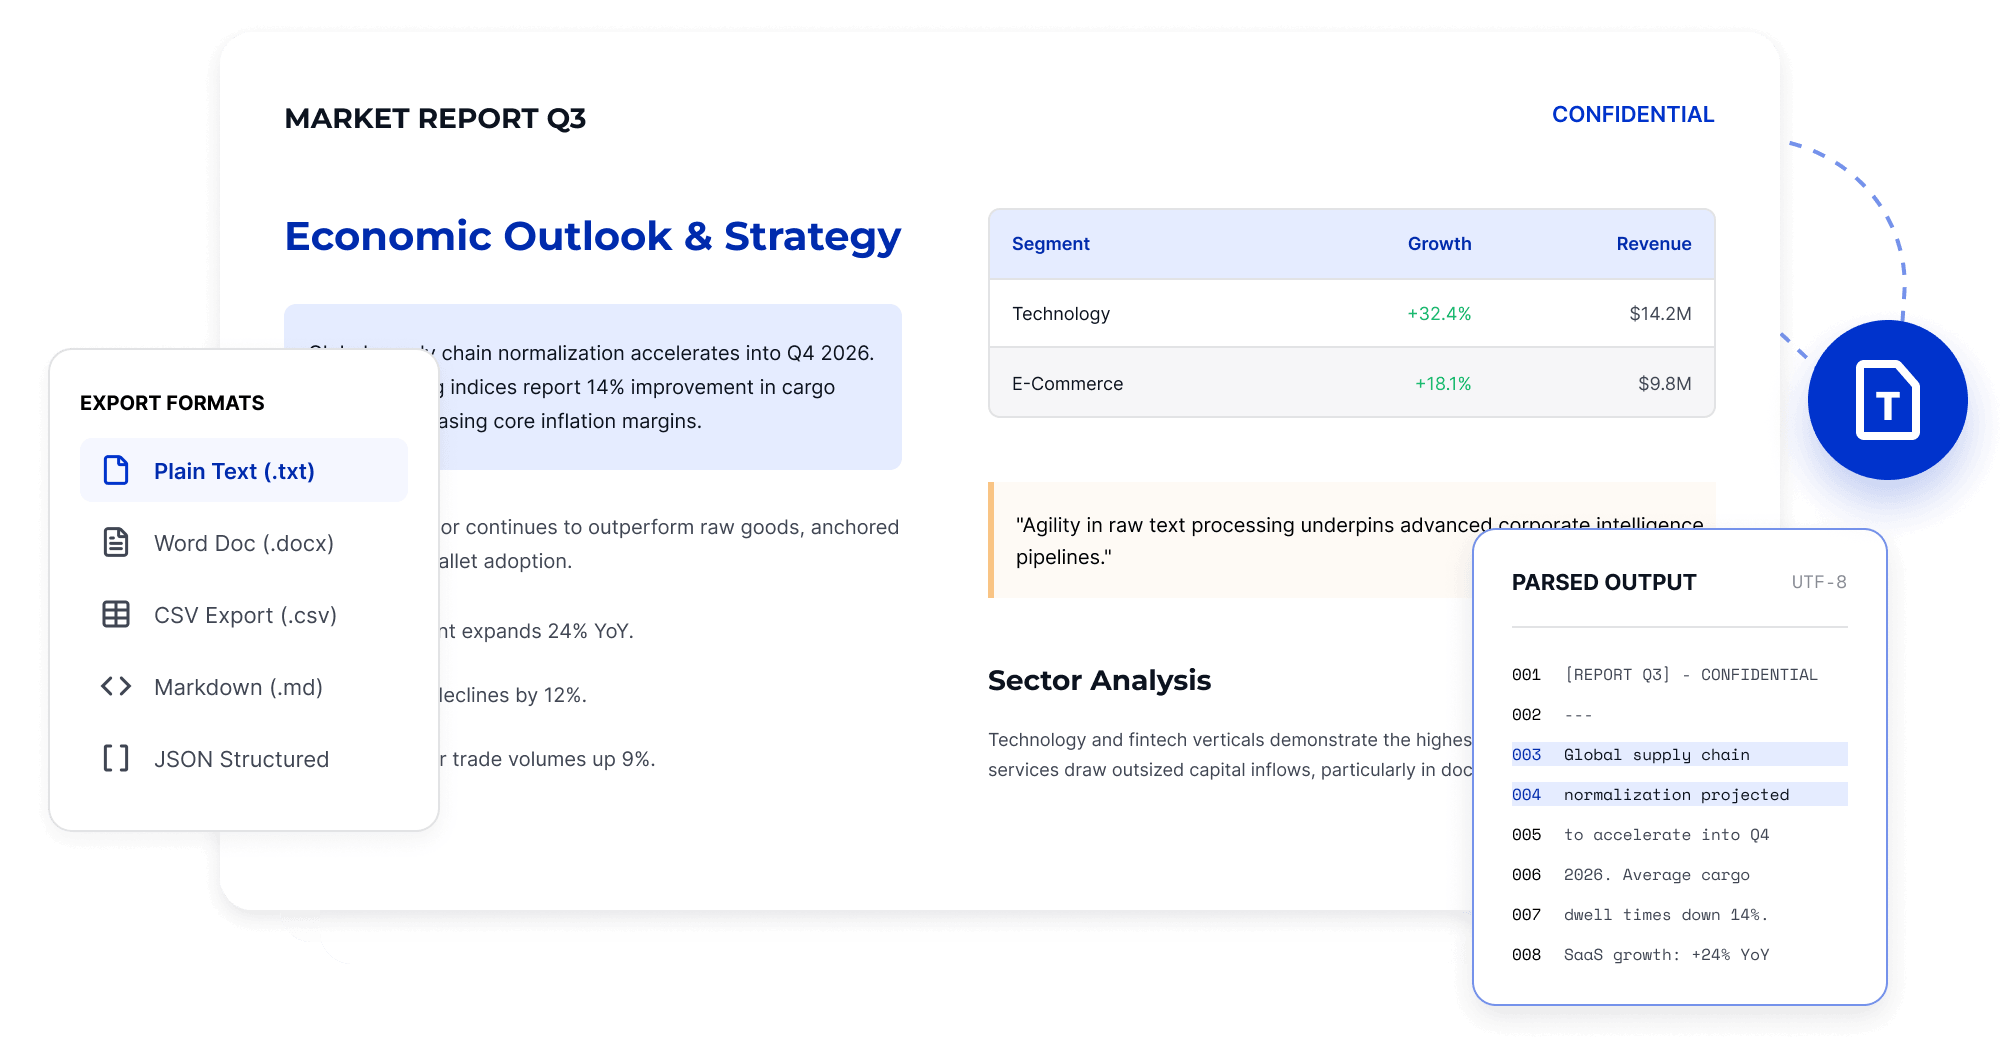
Extraheer doorzoekbare tekst uit rapporten, contracten en lange documenten om handmatig kopiëren en het ordenen per pagina te verminderen, waardoor bewerken, raadplegen en analyseren eenvoudiger wordt.
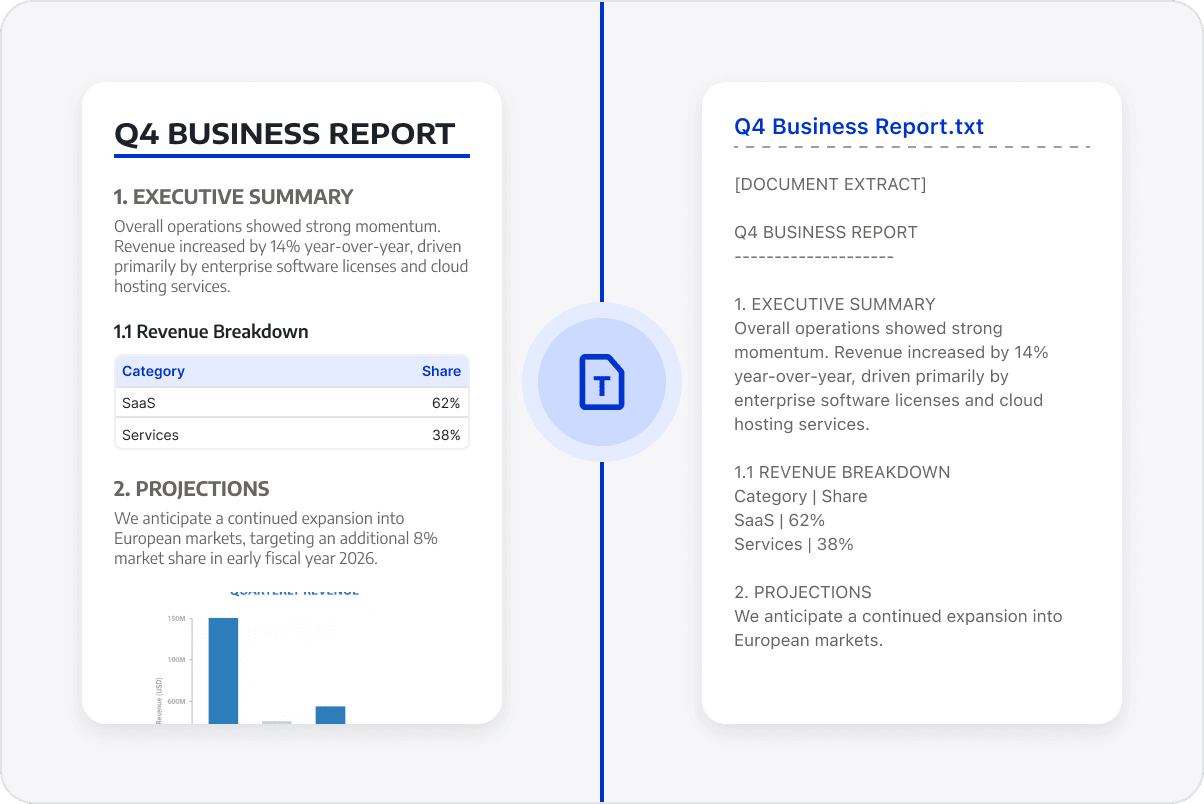
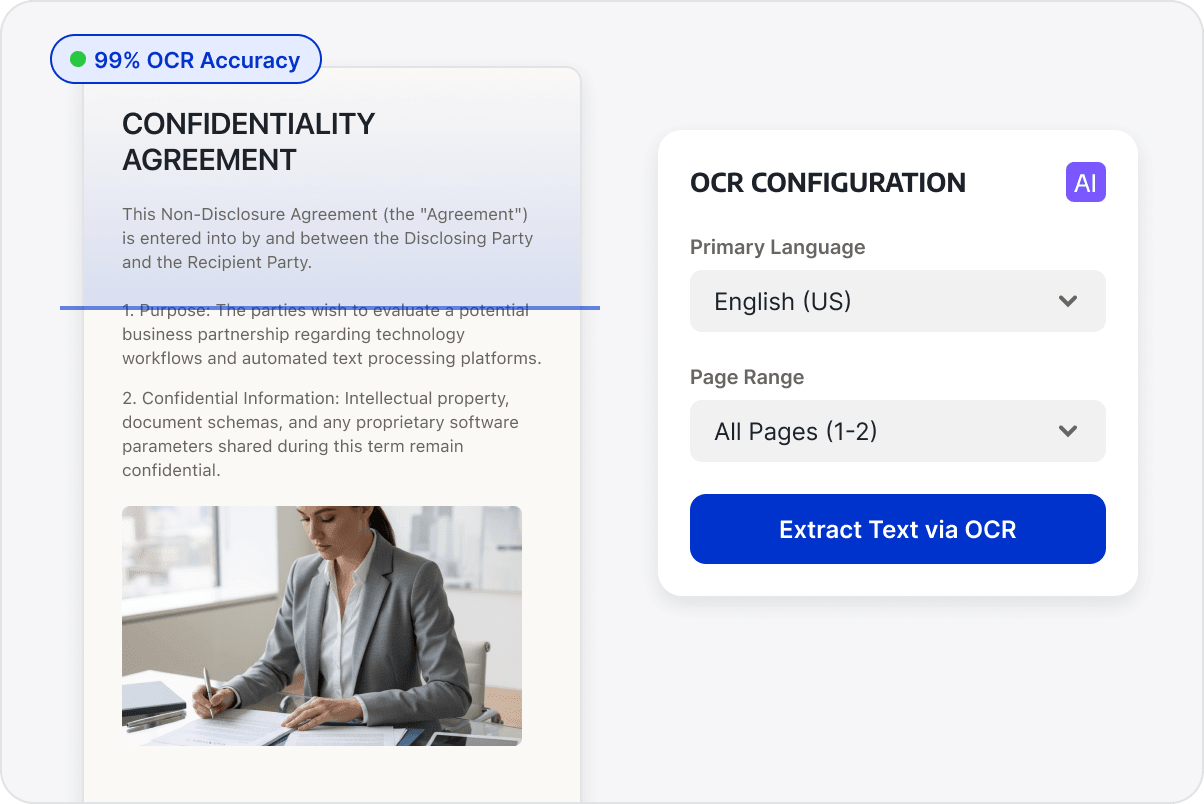
Tekst herkennen in gescande PDF's
Gebruik OCR om tekst in gescande pagina's en op afbeeldingen gebaseerde PDF's te herkennen vóór extractie.
Hergebruik de geëxtraheerde tekst
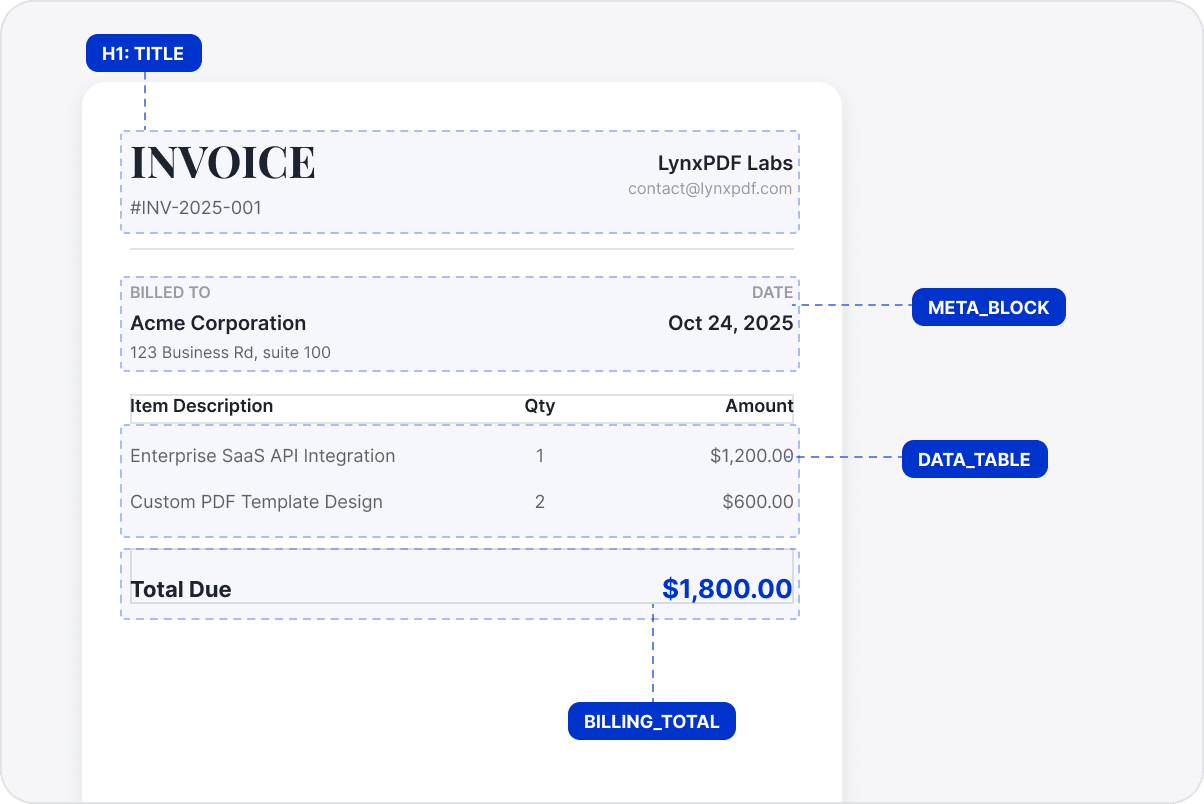
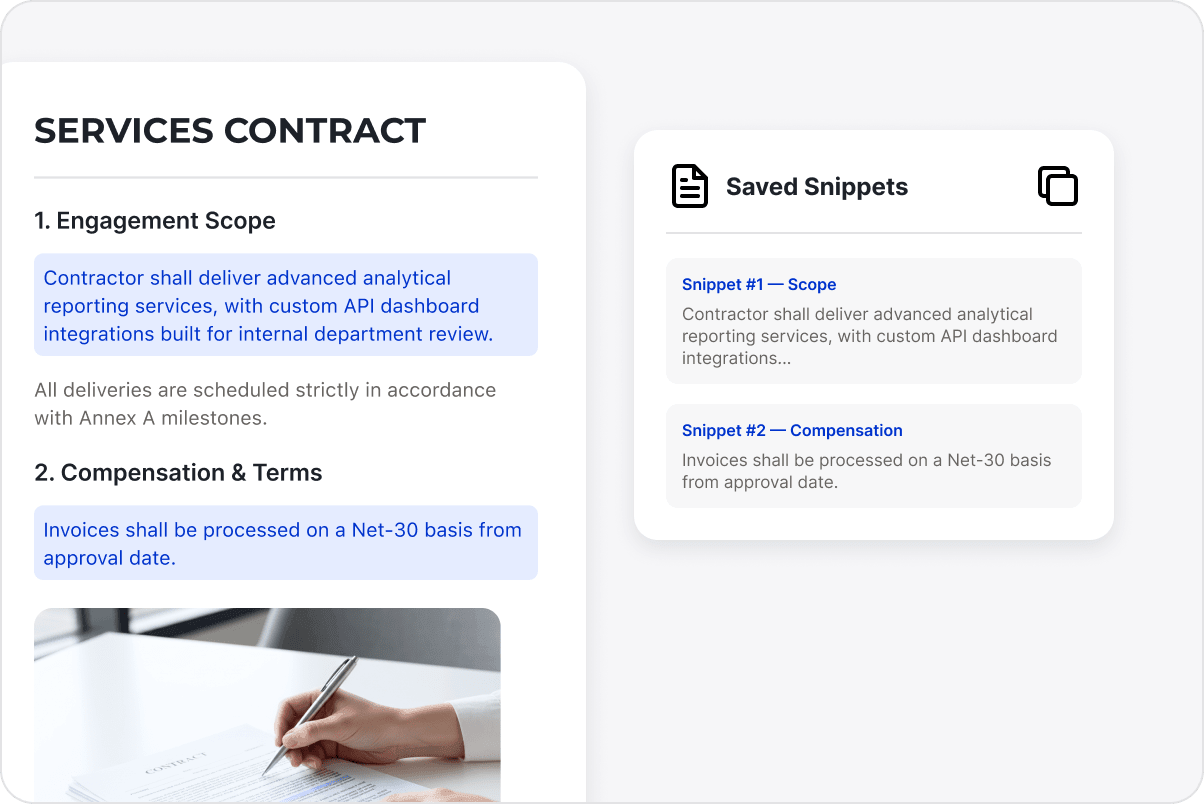
Organiseer de geëxtraheerde tekst in de oorspronkelijke leesvolgorde en behoud waar mogelijk kopjes, alinea's en belangrijke inhoudelijke verbanden om herformattering te minimaliseren.
Verder werken met de geëxtraheerde tekst
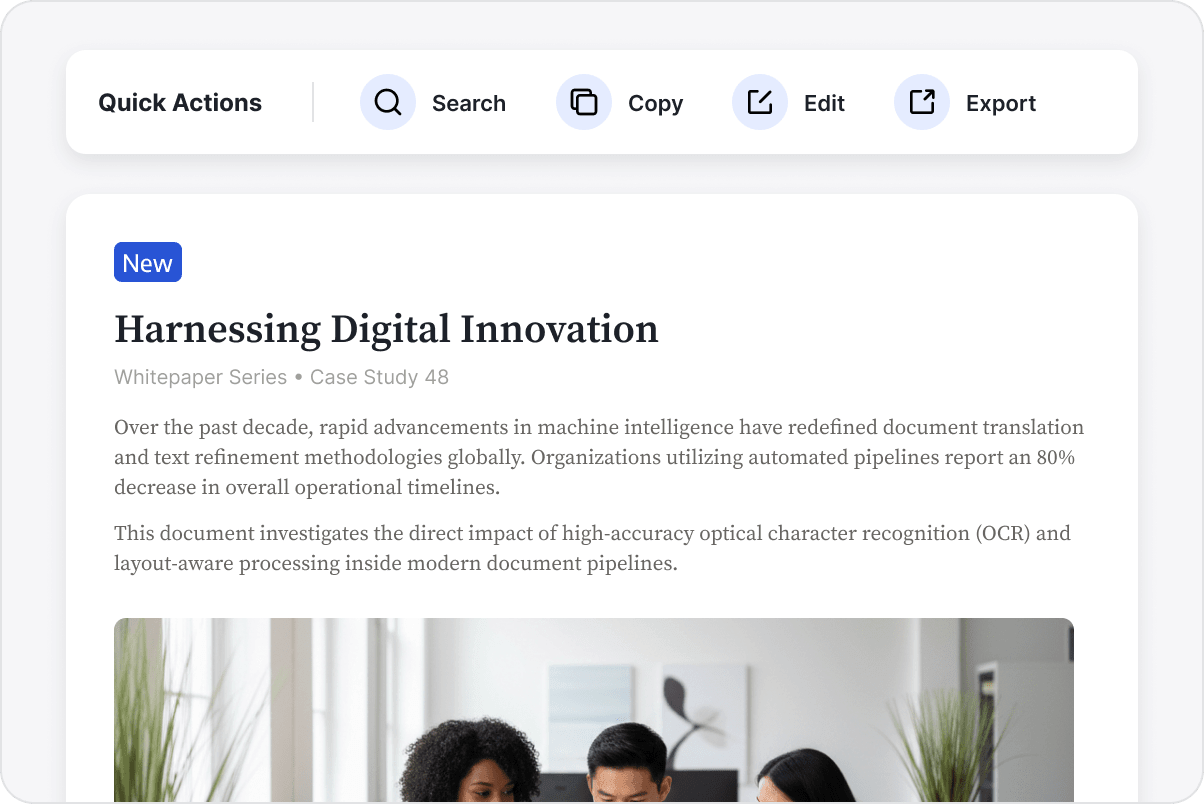
Gebruik de geëxtraheerde tekst voor notities, gegevensorganisatie, inhoudsbeoordeling of interne kennisvastlegging, waardoor het minder vaak nodig is om pdf's opnieuw te openen om inhoud te zoeken en te kopiëren.
Ga verder met het gebruik van de geëxtraheerde tekst.
Blijf de geëxtraheerde tekst gebruiken voor notities, inhoudelijke beoordeling, gegevensorganisatie en kennisvastlegging, waardoor herhaaldelijk zoeken in het PDF-bestand wordt verminderd.
Toegang tot de LynxPDF Expertbibliotheek
Toekomstgerichte inzichten en strategische gidsen voor enterprise documentbeheer.