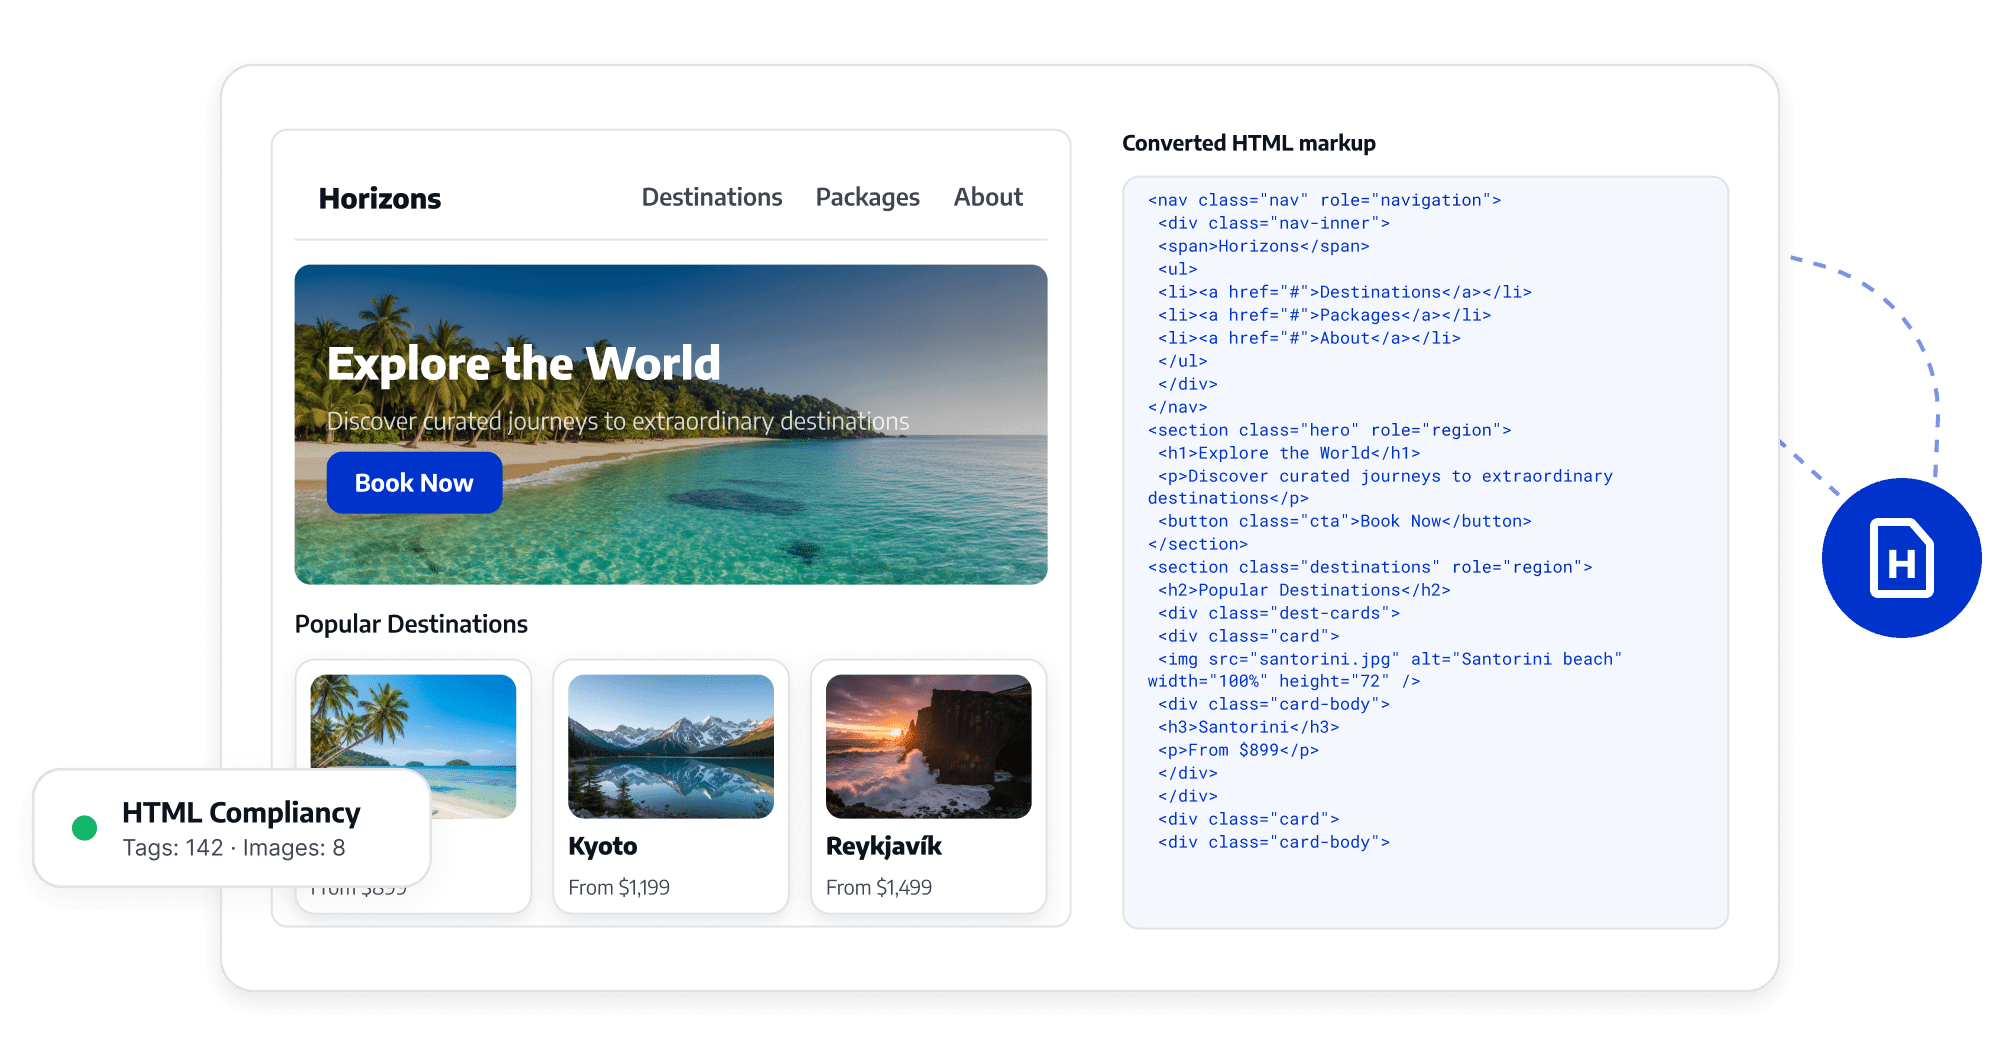
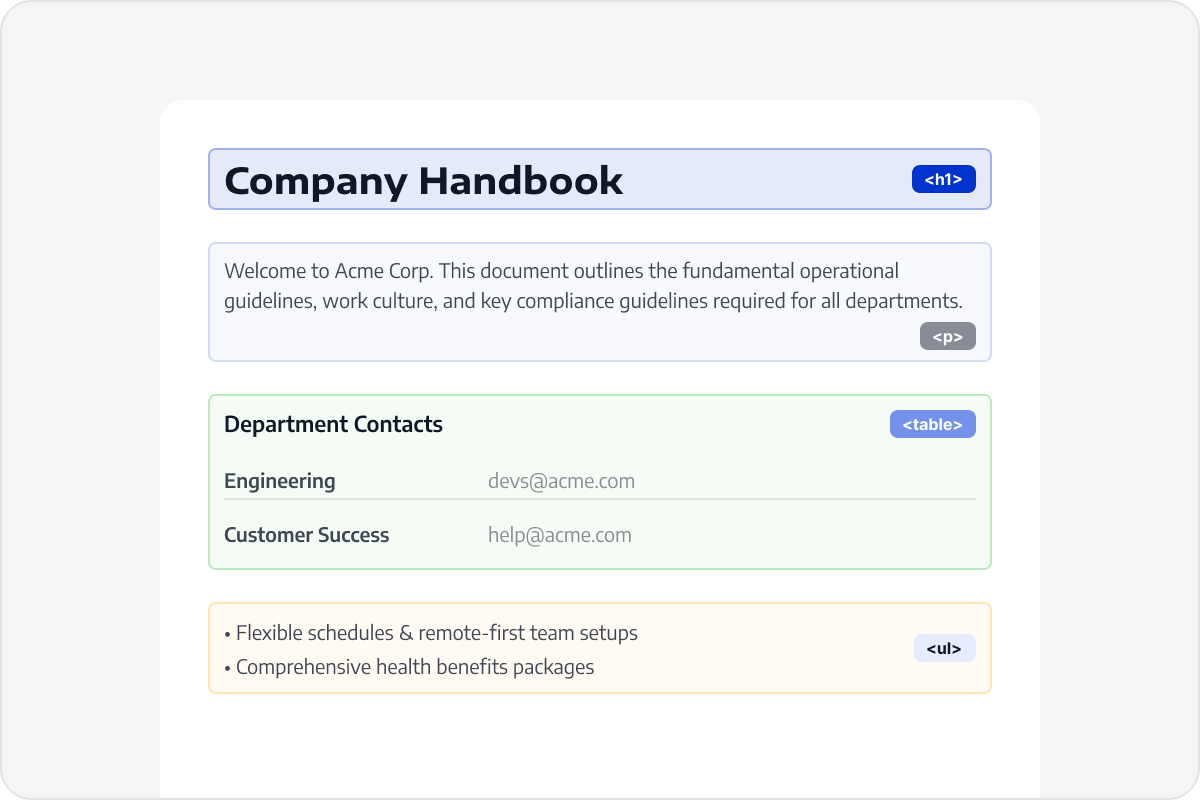
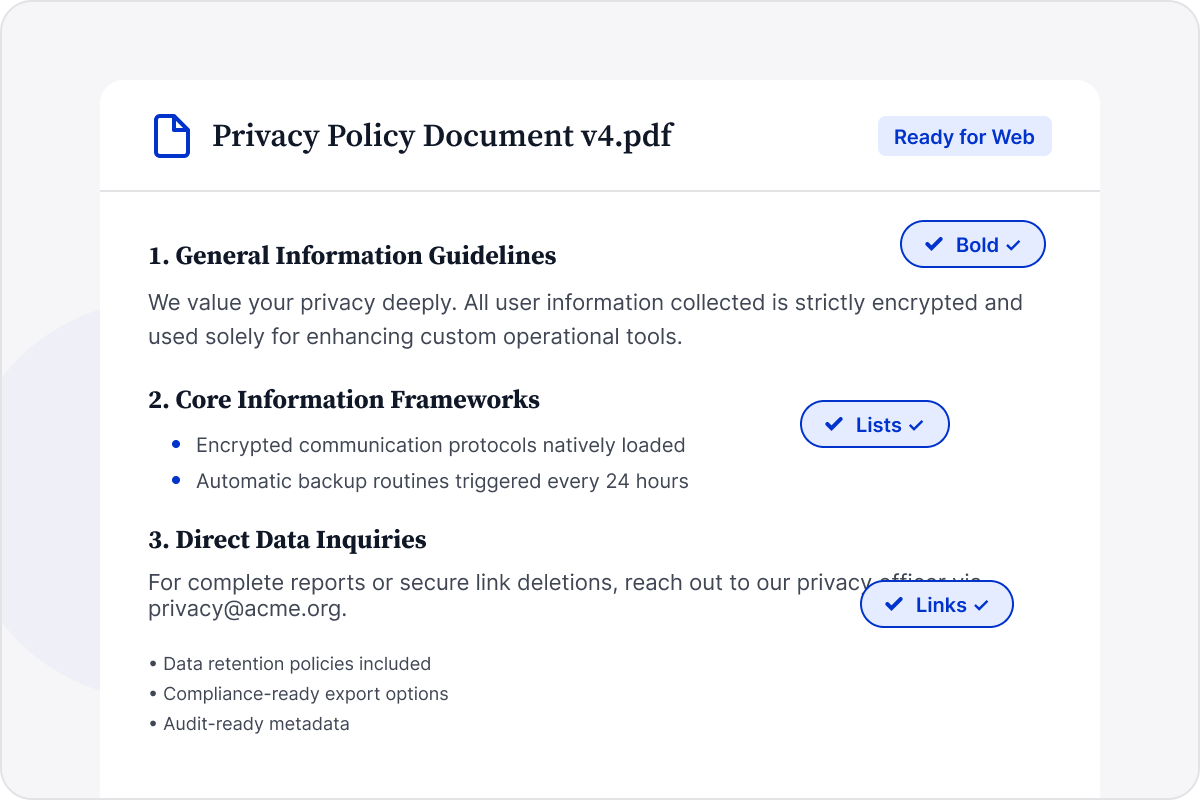
Identificeer tekst, afbeeldingen, lettertypen, kleuren en basislay-outinformatie in het PDF-bestand om de inhoudelijke en visuele basis te creëren voor het genereren van HTML.
HTML-bestanden genereren
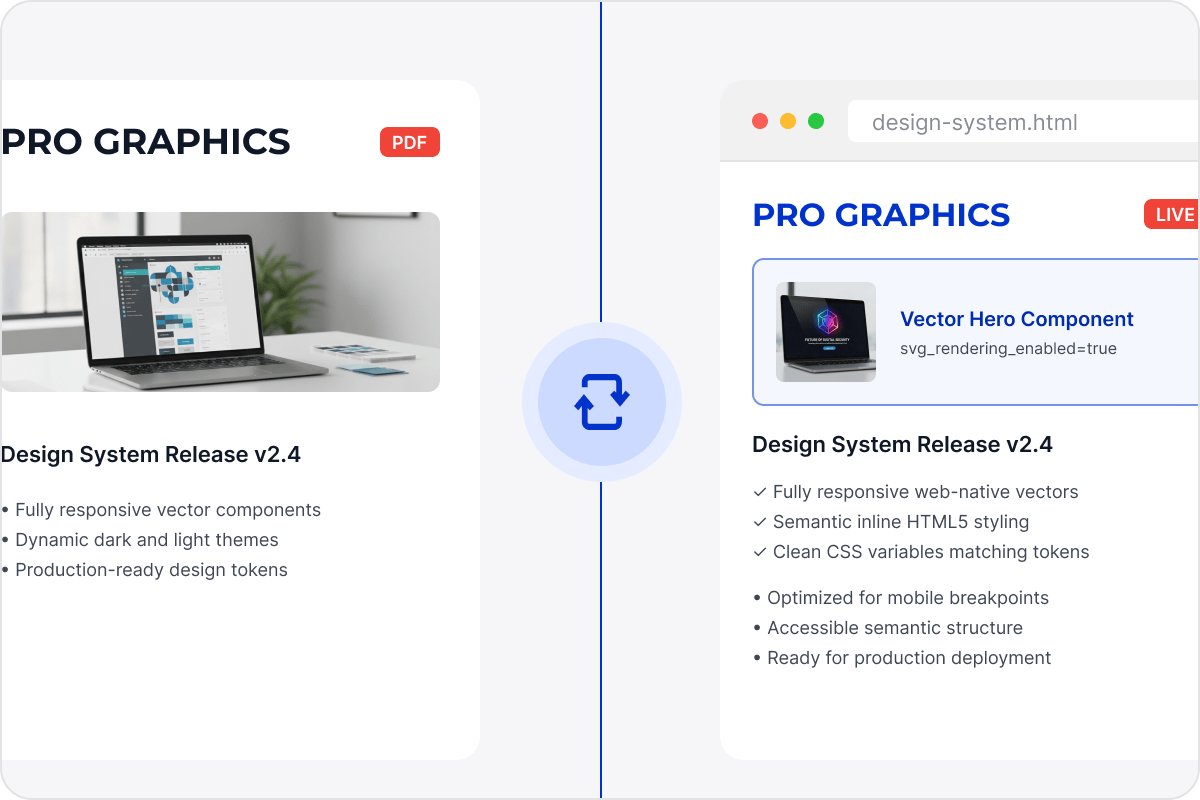
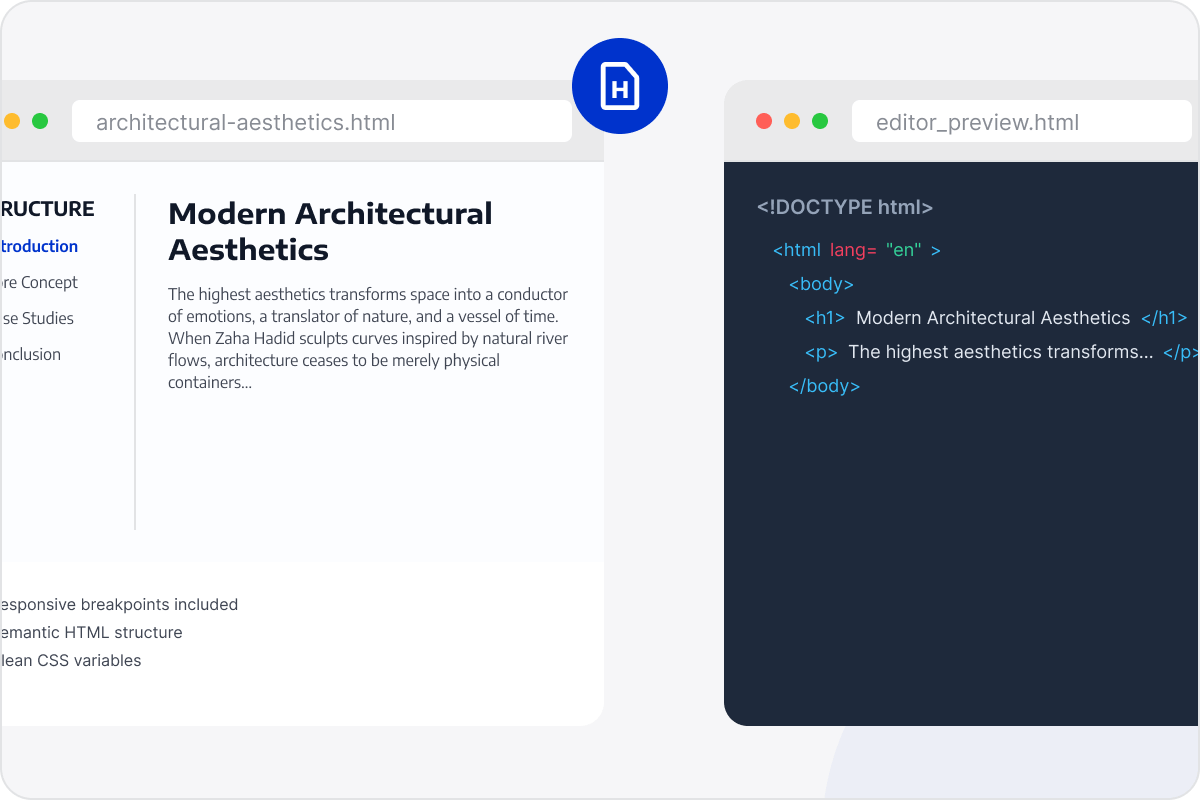
Genereer HTML uit de geparseerde inhoud, waarbij lettertypen, kleuren, spatiëring en paginarelaties zoveel mogelijk behouden blijven, waardoor het minder nodig is om CSS helemaal opnieuw te schrijven.
Verminder reconstructiefouten
Verminder handmatig kopiëren en stijlaanpassingen ten opzichte van de PDF, waardoor het risico op verschillen in tekst, afbeeldingen en pagina-indeling tijdens de reconstructie kleiner wordt.
Zorg voor consistente conversies.
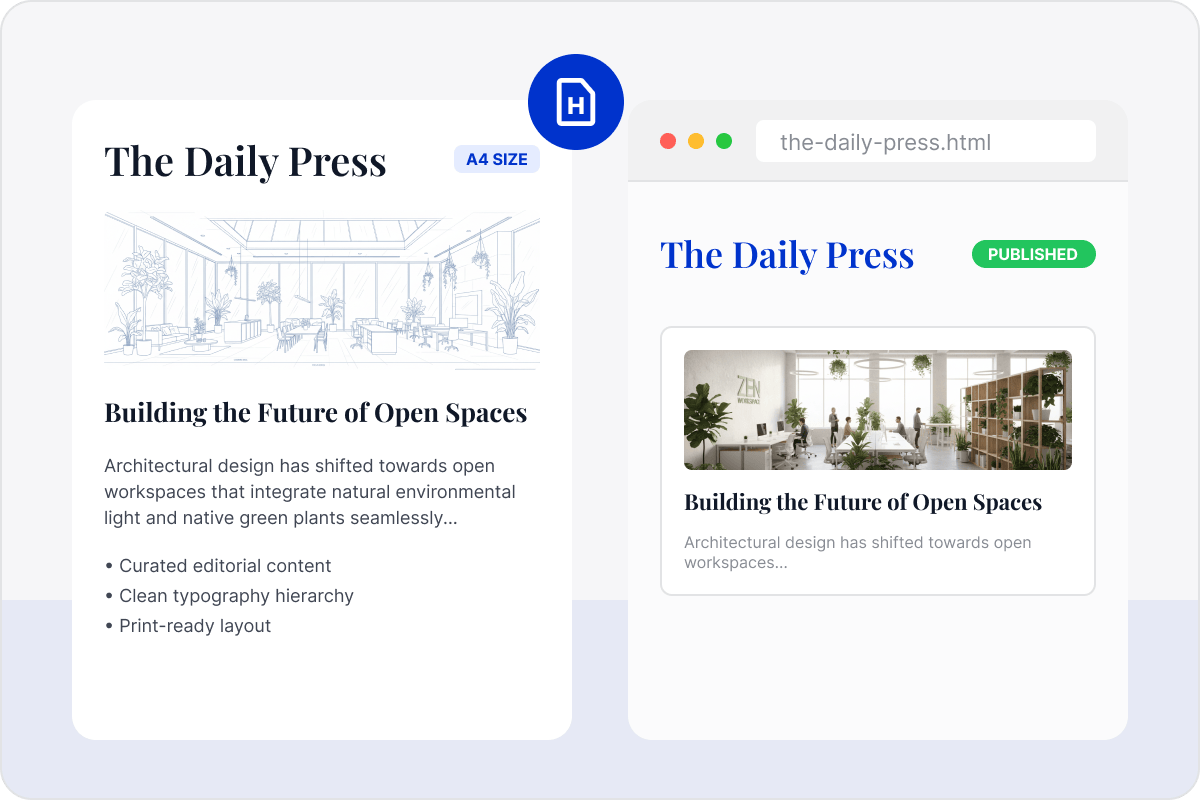
Gebruik dezelfde procedure voor meerdere PDF-bestanden om de paginastructuur en basisstijl consistent te houden en lay-outverschillen tussen bestanden te minimaliseren.
Maak het onderhoud van content eenvoudiger.
Bekijk de geconverteerde inhoud en lay-out en werk vervolgens de tekst, afbeeldingen en stijlen in HTML bij zonder telkens alles opnieuw vanuit de PDF te hoeven genereren.
Toegang tot de LynxPDF Expertbibliotheek
Toekomstgerichte inzichten en strategische gidsen voor enterprise documentbeheer.