Ekstrak teks yang boleh dicari daripada laporan, kontrak dan dokumen panjang untuk mengurangkan penyalinan manual dan pengaturan halaman demi halaman, menjadikannya lebih mudah untuk diedit, dirujuk dan dianalisis.
Mengenal Teks dalam PDF yang Diimbas
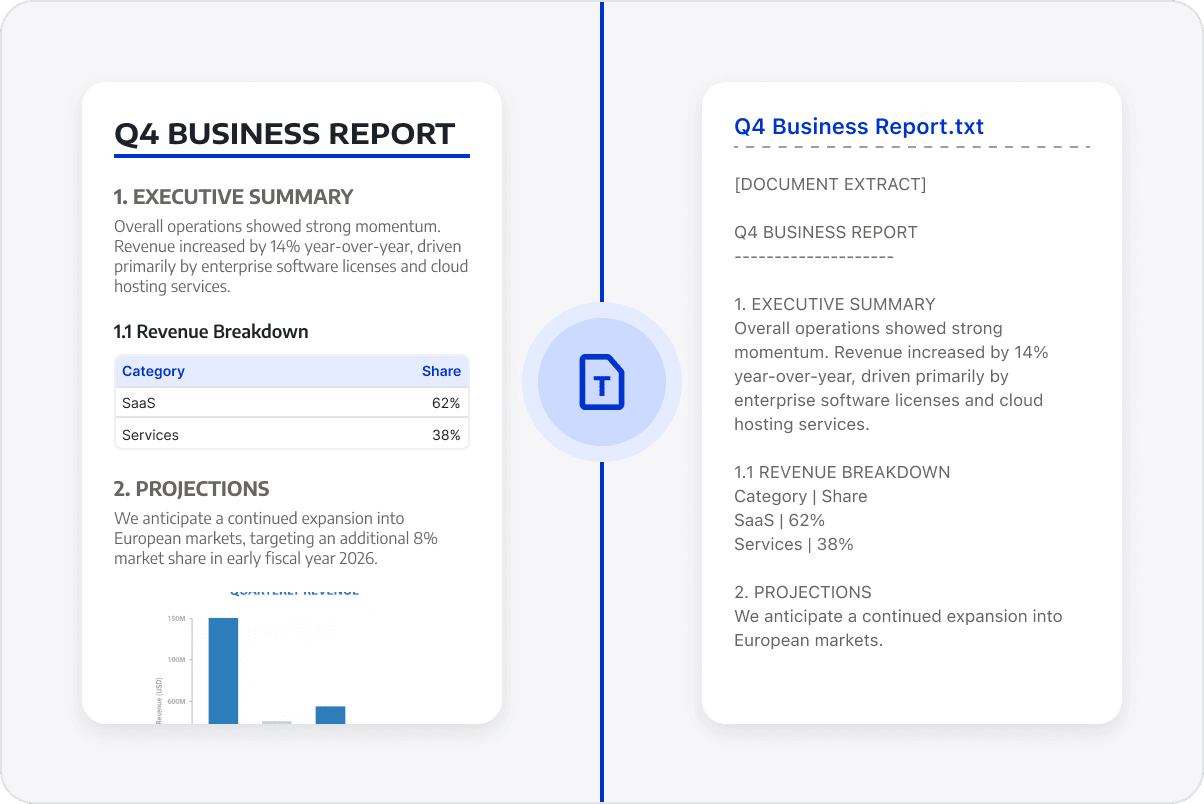
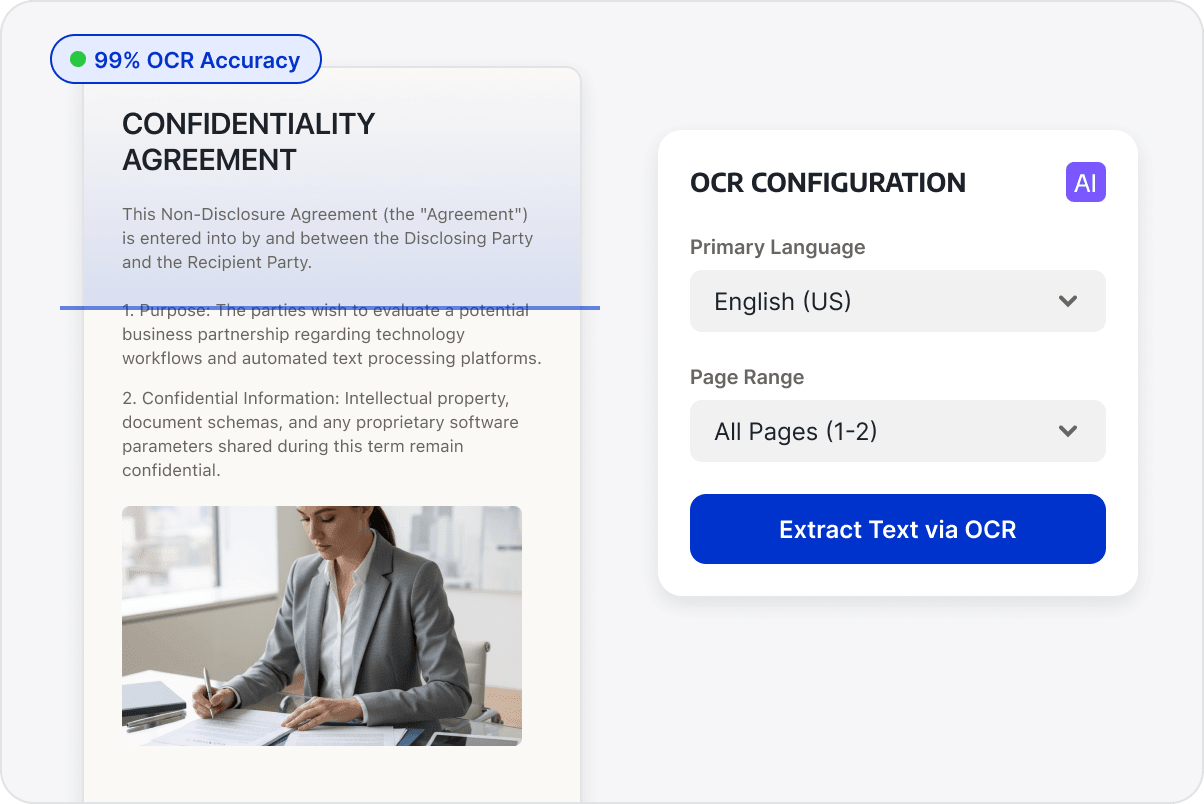
Gunakan OCR untuk mengecam teks dalam halaman yang diimbas dan PDF berasaskan imej sebelum pengekstrakan.
Gunakan Semula Teks yang Diekstrak
Susun teks yang diekstrak mengikut susunan bacaan asal dan pelihara tajuk, perenggan dan hubungan kandungan utama jika boleh untuk mengurangkan pemformatan semula.
Teruskan Bekerja dengan Teks yang Diekstrak
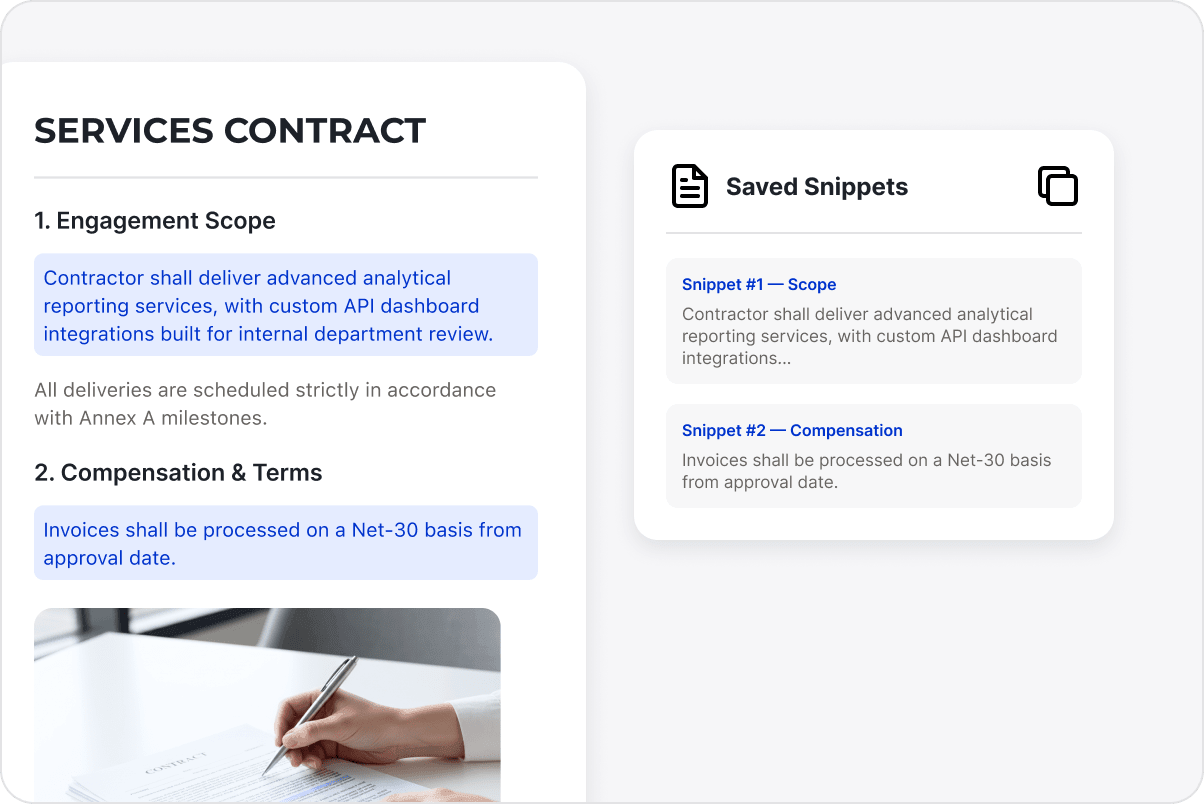
Gunakan teks yang diekstrak untuk nota, organisasi data, semakan kandungan atau pengumpulan pengetahuan dalaman, sekali gus mengurangkan keperluan untuk membuka semula PDF bagi mencari dan menyalin kandungan.
Teruskan Menggunakan Teks yang Diekstrak
Teruskan menggunakan teks yang diekstrak untuk nota, semakan kandungan, penyusunan data dan pengumpulan pengetahuan, sekali gus mengurangkan carian berulang melalui PDF.
Akses Perpustakaan Pakar LynxPDF
Wawasan berpandangan jauh dan panduan strategik untuk pengurusan dokumen perusahaan.