아프가니스탄
올란드 제도
알바니아
알제리
아메리칸사모아
안도라
앙골라
앵귈라
앤티가 바부다
아르헨티나
아르메니아
아루바
오스트레일리아
오스트리아
아제르바이잔
바하마
바레인
방글라데시
바베이도스
벨라루스
벨기에
벨리즈
베냉
버뮤다
부탄
볼리비아
보네르, 신트외스타티위스, 사바
보스니아 헤르체고비나
보츠와나
부베섬
브라질
영국령 인도양 지역
영국령 버진아일랜드
브루나이
불가리아
부르키나파소
부룬디
캄보디아
카메룬
캐나다
카보베르데
케이맨 제도
중앙아프리카 공화국
차드
칠레
중국
크리스마스섬
코코스 제도
콜롬비아
코모로
콩고
쿡 제도
코스타리카
코트디부아르
크로아티아
퀴라소
키프로스
체코
덴마크
지부티
도미니카
도미니카 공화국
에콰도르
이집트
엘살바도르
적도 기니
에리트레아
에스토니아
에티오피아
포클랜드 제도
페로 제도
피지
핀란드
프랑스
프랑스령 기아나
프랑스령 폴리네시아
프랑스령 남부 지역
가봉
감비아
조지아
독일
가나
지브롤터
그리스
그린란드
그레나다
과들루프
괌
과테말라
건지 섬
기니
기니비사우
가이아나
아이티
허드 맥도널드 제도
바티칸
온두라스
홍콩
헝가리
아이슬란드
인도
인도네시아
이라크
아일랜드
맨 섬
이스라엘
이탈리아
자메이카
일본
저지 섬
요르단
카자흐스탄
케냐
키리바시
쿠웨이트
키르기스스탄
라오스
라트비아
레바논
레소토
라이베리아
리비아
리히텐슈타인
리투아니아
룩셈부르크
마카오
북마케도니아
마다가스카르
말라위
말레이시아
몰디브
말리
몰타
마셜 제도
마르티니크
모리타니
모리셔스
마요트
멕시코
미크로네시아
몰도바
모나코
몽골
몬테네그로
몬트세랫
모로코
모잠비크
미얀마
나미비아
나우루
네팔
네덜란드
네덜란드령 안틸레스
누벨칼레도니
뉴질랜드
니카라과
니제르
나이지리아
니우에
노퍽섬
북마리아나 제도
노르웨이
오만
파키스탄
팔라우
팔레스타인
파나마
파푸아뉴기니
파라과이
페루
필리핀
핏케언 제도
폴란드
포르투갈
푸에르토리코
카타르
세르비아
레위니옹
루마니아
러시아
르완다
사우스조지아 사우스샌드위치 제도
세인트헬레나
세인트키츠 네비스
세인트루시아
세인트마틴
생피에르 미클롱
세인트빈센트 그레나딘
사모아
산마리노
상투메 프린시페
사우디아라비아
세네갈
세이셸
시에라리온
싱가포르
슬로바키아
슬로베니아
솔로몬 제도
소말리아
남아프리카 공화국
대한민국
스페인
스리랑카
수단
수리남
스발바르 얀마옌
에스와티니
스웨덴
스위스
대만
타지키스탄
탄자니아
태국
동티모르
토고
토켈라우
통가
트리니다드 토바고
튀니지
튀르키예
투르크메니스탄
터크스 케이커스 제도
투발루
미국령 버진아일랜드
우간다
우크라이나
아랍에미리트
영국
미국
미국령 해외 제도
우루과이
우즈베키스탄
바누아투
베네수엘라
베트남
왈리스 푸투나
서사하라
예멘
잠비아
짐바브웨
일치하는 결과가 없습니다
+93-아프가니스탄
+355-알바니아
+213-알제리
+1-미국령 사모아
+376-안도라
+244-앙골라
+1-앵귈라
+72-남극
+1-앤티가 바부다
+54-아르헨티나
+374-아르메니아
+297-아루바
+61-오스트레일리아
+43-오스트리아
+994-아제르바이잔
+1-바하마
+973-바레인
+880-방글라데시
+1-바베이도스
+375-벨라루스
+32-벨기에
+501-벨리즈
+229-베냉
+1-버뮤다
+975-부탄
+591-볼리비아
+387-보스니아 헤르체고비나
+267-보츠와나
+55-브라질
+246-영국령 인도양 지역
+673-브루나이
+359-불가리아
+226-부르키나파소
+257-부룬디
+855-캄보디아
+237-카메룬
+1-캐나다
+238-카보베르데
+1-케이맨 제도
+236-중앙아프리카 공화국
+235-차드
+56-칠레
+86-중국
+61-크리스마스섬
+61-코코스 제도
+57-콜롬비아
+269-코모로
+243-콩고 민주 공화국
+242-콩고 공화국
+682-쿡 제도
+506-코스타리카
+225-코트디부아르
+385-크로아티아
+53-쿠바
+357-키프로스
+420-체코
+45-덴마크
+253-지부티
+1-도미니카 연방
+1-도미니카 공화국
+593-에콰도르
+20-이집트
+503-엘살바도르
+240-적도 기니
+291-에리트레아
+372-에스토니아
+268-에스와티니
+251-에티오피아
+500-포클랜드 제도
+298-페로 제도
+679-피지
+358-핀란드
+33-프랑스
+594-프랑스령 기아나
+689-프랑스령 폴리네시아
+241-가봉
+220-감비아
+995-조지아
+49-독일
+233-가나
+350-지브롤터
+30-그리스
+299-그린란드
+1-그레나다
+590-과들루프
+1-괌
+502-과테말라
+224-기니
+245-기니비사우
+592-가이아나
+509-아이티
+504-온두라스
+852-홍콩
+36-헝가리
+354-아이슬란드
+91-인도
+62-인도네시아
+98-이란
+964-이라크
+353-아일랜드
+972-이스라엘
+39-이탈리아
+1-자메이카
+81-일본
+962-요르단
+7-카자흐스탄
+254-케냐
+686-키리바시
+850-조선민주주의인민공화국
+82-대한민국
+965-쿠웨이트
+996-키르기스스탄
+856-라오스
+371-라트비아
+961-레바논
+266-레소토
+231-라이베리아
+218-리비아
+423-리히텐슈타인
+370-리투아니아
+352-룩셈부르크
+853-마카오
+261-마다가스카르
+265-말라위
+60-말레이시아
+960-몰디브
+223-말리
+356-몰타
+692-마셜 제도
+596-마르티니크
+222-모리타니
+230-모리셔스
+262-마요트
+52-멕시코
+691-미크로네시아 연방
+373-몰도바
+377-모나코
+976-몽골
+382-몬테네그로
+1-몬트세랫
+212-모로코
+258-모잠비크
+95-미얀마
+264-나미비아
+674-나우루
+977-네팔
+31-네덜란드
+687-누벨칼레도니
+64-뉴질랜드
+505-니카라과
+227-니제르
+234-나이지리아
+683-니우에
+672-노퍽섬
+389-북마케도니아
+1-북마리아나 제도
+47-노르웨이
+968-오만
+92-파키스탄
+680-팔라우
+970-팔레스타인
+507-파나마
+675-파푸아뉴기니
+595-파라과이
+51-페루
+63-필리핀
+48-폴란드
+351-포르투갈
+1-푸에르토리코
+974-카타르
+262-레위니옹
+40-루마니아
+7-러시아
+250-르완다
+590-생바르텔레미
+290-세인트헬레나
+1-세인트키츠 네비스
+1-세인트루시아
+590-생마르탱
+508-생피에르 미클롱
+1-세인트빈센트 그레나딘
+685-사모아
+378-산마리노
+239-상투메 프린시페
+966-사우디아라비아
+221-세네갈
+381-세르비아
+248-세이셸
+232-시에라리온
+65-싱가포르
+1-신트마르턴
+421-슬로바키아
+386-슬로베니아
+677-솔로몬 제도
+252-소말리아
+27-남아프리카 공화국
+211-남수단
+34-스페인
+94-스리랑카
+249-수단
+597-수리남
+46-스웨덴
+41-스위스
+963-시리아
+886-타이완
+992-타지키스탄
+255-탄자니아
+66-태국
+670-동티모르
+228-토고
+690-토켈라우
+676-통가
+1-트리니다드 토바고
+216-튀니지
+90-튀르키예
+993-투르크메니스탄
+1-터크스 케이커스 제도
+688-투발루
+256-우간다
+380-우크라이나
+971-아랍에미리트
+44-영국
+1-미국
+598-우루과이
+998-우즈베키스탄
+678-바누아투
+58-베네수엘라
+84-베트남
+1-영국령 버진아일랜드
+1-미국령 버진아일랜드
+681-왈리스 푸투나
+967-예멘
+260-잠비아
+263-짐바브웨
No data
제품
LynxPDF
기업용
LynxPDF for Windows
LynxPDF for Mac
iOS용 LynxPDF
신규
LynxPDF for Android
신규
LynxPDF Web
관리자 콘솔
온라인 도구
PDF에서 Word로
PDF에서 Excel로
PDF에서 PPT로
PDF에서 이미지로
PDF 병합
PDF 압축
PDF 편집
PDF OCR
일괄 PDF에서 Word로
일괄 압축
모든 도구
주요 기능
PDF 편집
PDF 변환
PDF 주석 추가
PDF 서명
양식 작성
PDF 비교
PDF 민감 정보 영구 삭제
신규
PDF 보안 설정
PDF 열람
PDF OCR
PDF 페이지 관리
PDF 분할
신규
PDF 텍스트를 음성으로 변환
신규
전체 기능 보기
솔루션
솔루션
교육
건설
제조
IT 서비스
의료
금융
물류
법률 서비스
인사
조달
컨설팅 서비스
소매 및 전자상거래
부동산
회계팀
영업팀
정부 및 공공 부문
법무팀
보험 및 청구
미국 비영리단체
리소스
리소스
자주 묻는 질문
블로그
화이트페이퍼
신규
도입 사례
회사 소개
고객 문의
GDPR
제품 비교
요금 안내
파트너
영업 문의
무료 다운로드
로그인
English (U.S.)
English (Australia)
English (Canada)
English (U.K.)
Français
Français (Canada)
Español (México)
Español
العربية
Русский язык
中文 (简体)
中文 (繁體)
Português (Brasil)
Português (Portugal)
Deutsch
हिन्दी
Bahasa Indonesia
Bahasa Melayu
日本語 (にほんご)
Italiano
Nederlands
Türkçe
Polski
Українська
Svenska
Ελληνικά
ภาษาไทย (Phasa Thai)
Tiếng Việt
한국어
Română
Čeština
Magyar
Suomi
עברית
Norsk
Dansk
Slovenčina
Hrvatski
Català
English (U.S.)
English (Australia)
English (Canada)
English (U.K.)
Français
Français (Canada)
Español (México)
Español
العربية
Русский язык
中文 (简体)
中文 (繁體)
Português (Brasil)
Português (Portugal)
Deutsch
हिन्दी
Bahasa Indonesia
Bahasa Melayu
日本語 (にほんご)
Italiano
Nederlands
Türkçe
Polski
Українська
Svenska
Ελληνικά
ภาษาไทย (Phasa Thai)
Tiếng Việt
한국어
Română
Čeština
Magyar
Suomi
עברית
Norsk
Dansk
Slovenčina
Hrvatski
Català
제품
LynxPDF
기업용
LynxPDF for Windows
LynxPDF for Mac
iOS용 LynxPDF
신규
LynxPDF for Android
신규
LynxPDF Web
관리자 콘솔
온라인 도구
PDF에서 Word로
PDF에서 Excel로
PDF에서 PPT로
PDF에서 이미지로
PDF 병합
PDF 압축
PDF 편집
PDF OCR
일괄 PDF에서 Word로
일괄 압축
모든 도구
주요 기능
PDF 편집
PDF 변환
PDF 주석 추가
PDF 서명
양식 작성
PDF 비교
PDF 민감 정보 영구 삭제
신규
PDF 보안 설정
PDF 열람
PDF OCR
PDF 페이지 관리
PDF 분할
신규
PDF 텍스트를 음성으로 변환
신규
전체 기능 보기
솔루션
교육
건설
제조
IT 서비스
의료
금융
물류
법률 서비스
인사
조달
컨설팅 서비스
소매 및 전자상거래
부동산
회계팀
영업팀
정부 및 공공 부문
법무팀
보험 및 청구
미국 비영리단체
리소스
자주 묻는 질문
블로그
화이트페이퍼
신규
도입 사례
회사 소개
고객 문의
GDPR
제품 비교
요금 안내
파트너
영업 문의
로그인
무료 다운로드
페이지를 복사하지 않고
PDF 텍스트
추출하기
PDF 텍스트를 TXT 파일로 추출하여 지속적인 편집, 검토, 콘텐츠 구성 및 지식 습득에 활용합니다.
영업팀에 문의하기
무료 체험하기
PDF에서 텍스트 추출
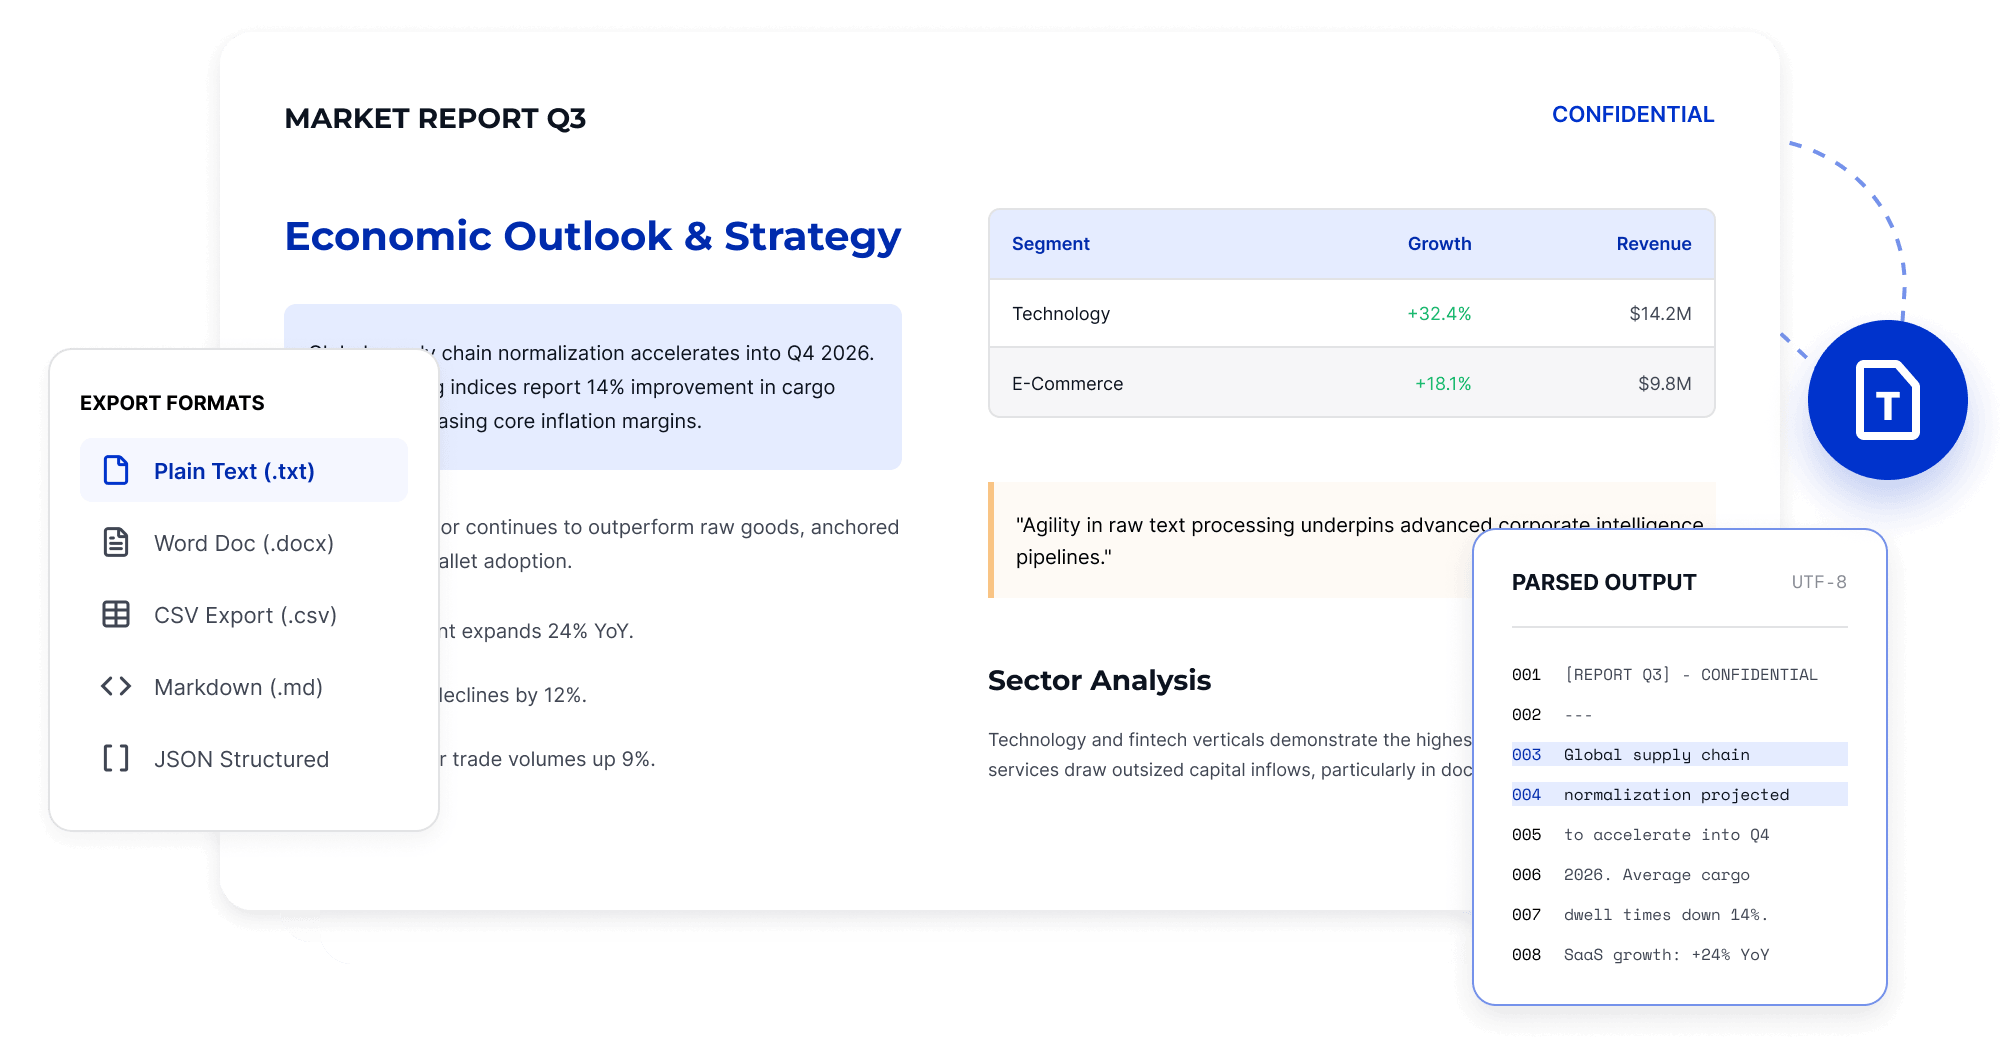
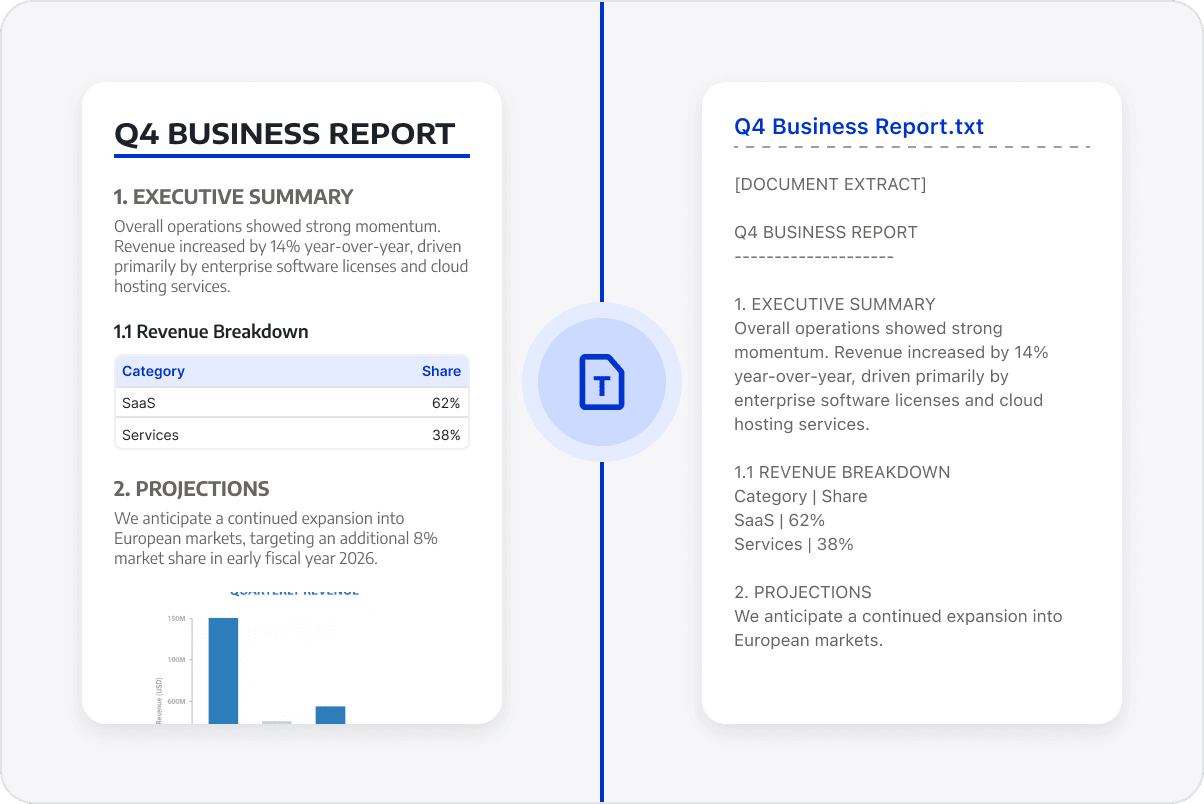
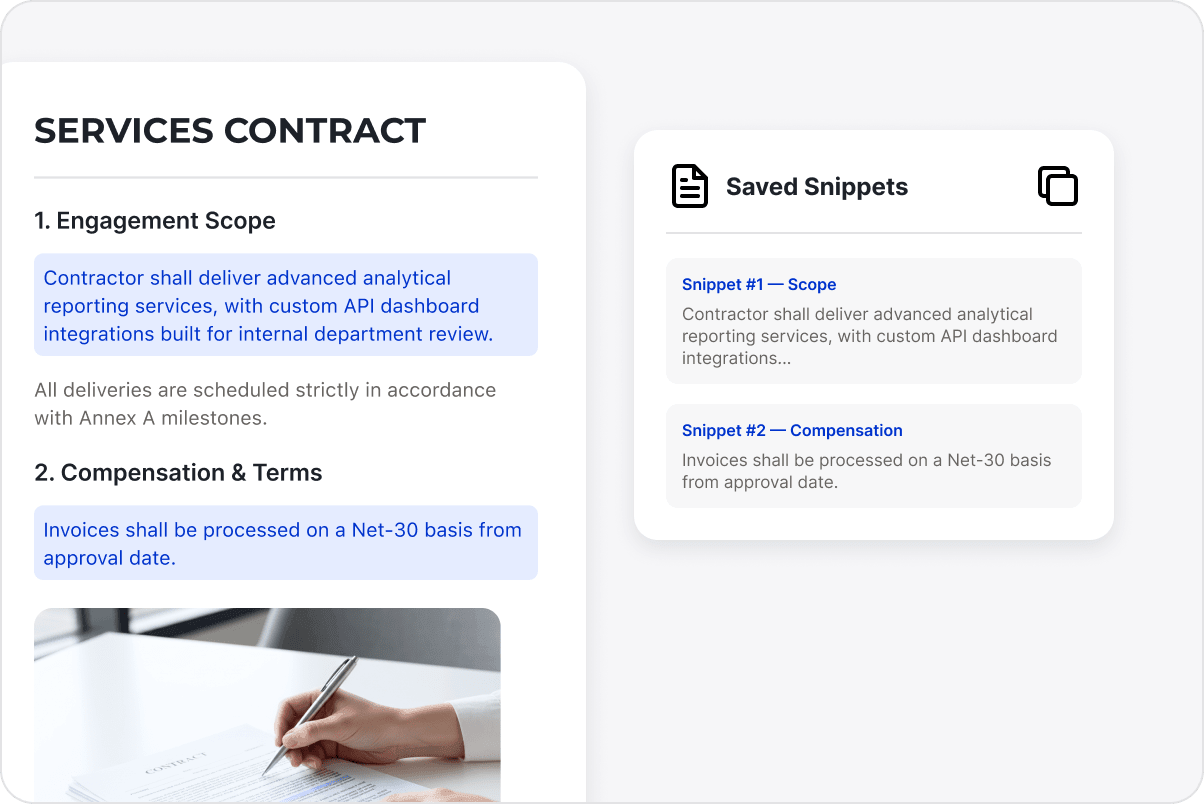
보고서, 계약서 및 장문의 문서에서 검색 가능한 텍스트를 추출하여 수동 복사 및 페이지별 정리 작업을 줄이고 편집, 참조 및 분석을 더욱 쉽게 만드세요.
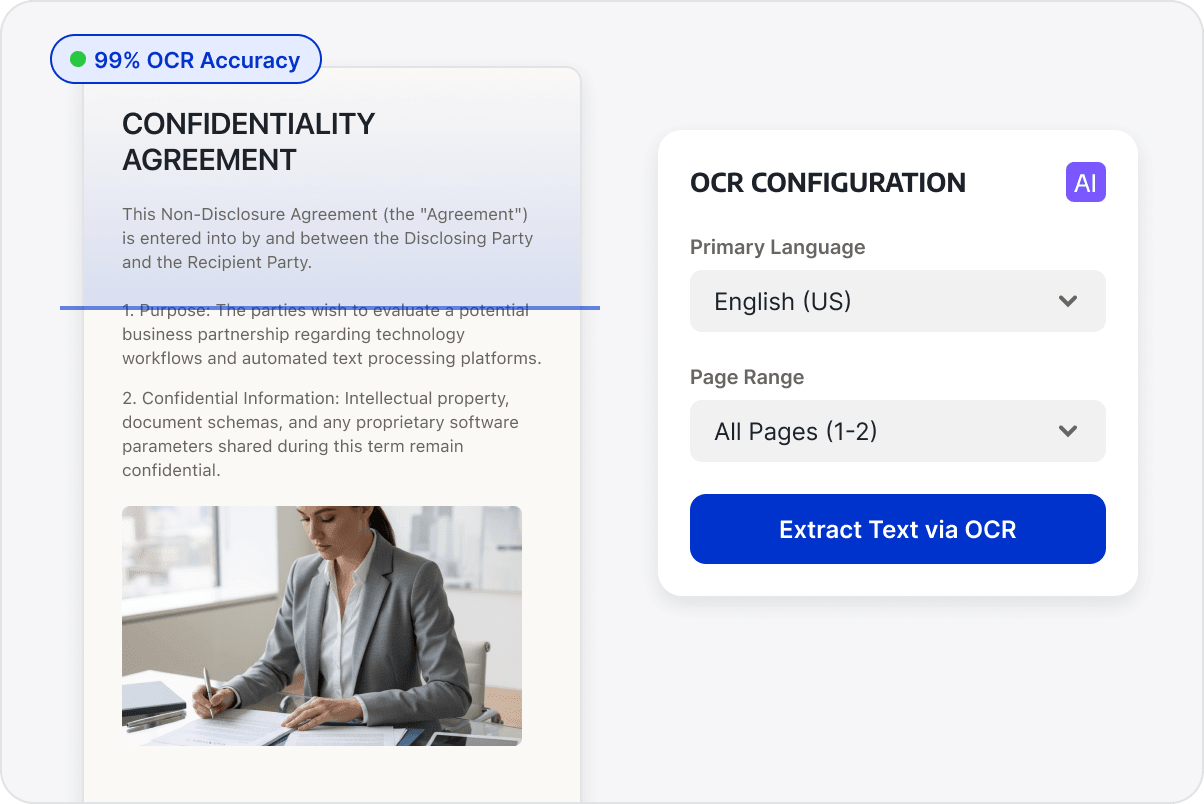
스캔한 PDF 파일에서 텍스트 인식
OCR을 사용하여 스캔한 페이지와 이미지 기반 PDF에서 텍스트를 추출하기 전에 텍스트를 인식합니다.
추출된 텍스트 재사용
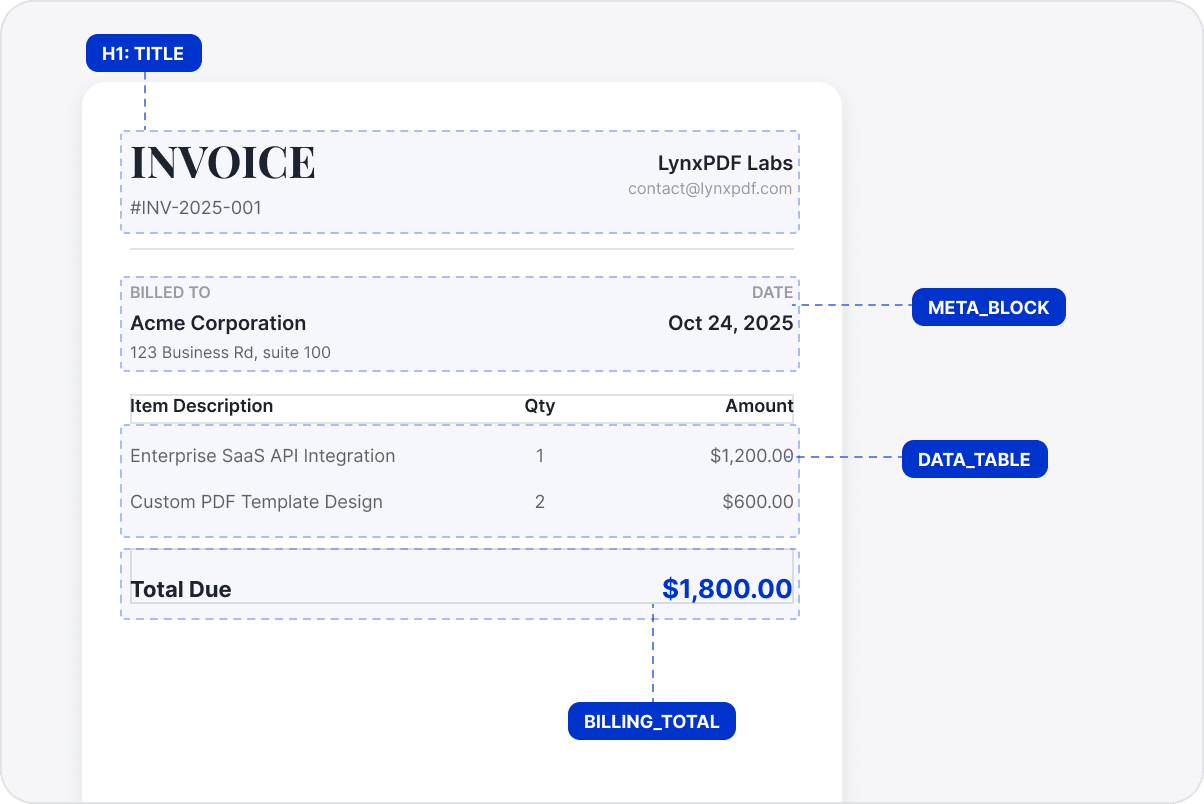
추출한 텍스트를 원래 읽기 순서대로 정리하고, 가능한 한 제목, 단락 및 주요 내용 관계를 유지하여 서식 변경을 최소화하십시오.
추출된 텍스트로 계속 작업하기
추출된 텍스트를 메모, 데이터 정리, 콘텐츠 검토 또는 내부 지식 캡처에 활용하여 콘텐츠를 찾고 복사하기 위해 PDF를 다시 열어야 하는 필요성을 줄이세요.
추출된 텍스트를 계속 사용하세요
추출한 텍스트를 메모, 콘텐츠 검토, 데이터 정리 및 지식 습득에 계속 활용하여 PDF에서 반복적으로 검색하는 횟수를 줄이십시오.
LynxPDF 전문가 라이브러리 접속
기업 문서 관리를 위한 미래 지향적 인사이트와 전략 가이드.
모든 백서 보기
모든 백서 보기
비즈니스 최적화 기능을 더 알아보세요
편집
양식 및 서명
보안
주석
OCR
열람
튜토리얼 및 인기 아티클 탐색
초보자 가이드
Which File Formats Can I Convert Using LynxPDF?
How to activate LynxPDF through License Code?
LynxPDF vs Kofax Power PDF
Why LynxPDF is the Best Adobe Acrobat Alternative for Enterprise Use?
How about LynxPDF’s OCR, and What are Its Main Advantages?
Does LynxPDF Support Batch Processing?
Does LynxPDF Support Digital Signatures?
Does LynxPDF Support Web, Mobile, and Team Collaboration?
자주 묻는 질문 더 보기
주요 인기 아티클
ABBYY FineReader PDF Alternative: Enterprise PDF Management Comparison
Thu. 27 Aug. 2026
Sejda vs LynxPDF: Linux Flexibility or Managed PDF Operations?
Wed. 26 Aug. 2026
Smallpdf vs LynxPDF: When PDF Work Needs More Control
Wed. 26 Aug. 2026
아티클 더 보기
영업 팀
에 문의하기
LynxPDF에 관한 모든 궁금증을 해결해 드립니다. 아래 양식을 작성해 주시면 영업 담당자가 신속히 연락드리겠습니다.
LynxPDF 및 LynxPDF 관리자 콘솔 14일 무료 체험 시작
귀하의 팀에 가장 적합한 요금제 상담
팀의 비즈니스 환경에 맞는 활용 시나리오 및 사례 연구 탐색
최대 50% 대량 구매 할인 혜택
비즈니스 이메일
성함
회사 웹사이트
국가/지역
검색 및 선택
전화번호
검색 및 선택
-
요구 사항 설명
0 / 1000